Decision models, Jev e Kev: il giudizio veloce dentro il software. Che cosa non va negli LLM, che cosa cambia, e come lo usiamo in Formula Finance.
Un movimento, una domanda
COMMISSIONE BONIFICO SEPA1,00 €
Che tipo di movimento è, per i costi bancari del conto?
Nessuna parola generata: una scelta fra sette voci, con le probabilità.
Le critiche · chi le muove
Il CEO di Jev contro il chatbot
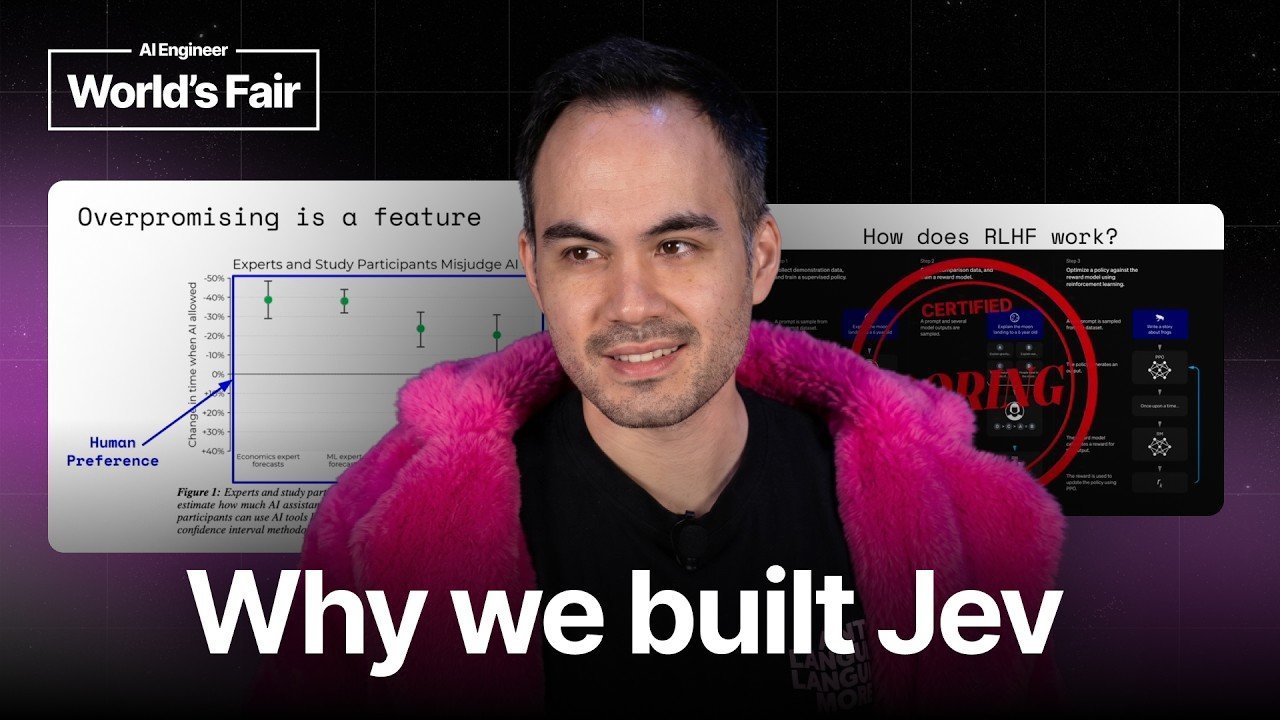
Diogo Almeida all'AI Engineer World's Fair. Immagine: copertina del video del talk su YouTube. Toccate le etichette per la sua storia.
Diogo Almeida guida TypeSafe, la società che ha creato Jev. Ha presentato l'idea quando l'azienda era ancora in modalità stealth, con un titolo che è già una tesi:
«I made ChatGPT, now I'm building what's next»
Alle sue spalle due slide: Overpromising is a feature e la ricetta dell'RLHF timbrata Certified boring.
Un LLM è costruito per affiancare una persona che rilegge. In un processo automatico nessuno rilegge ogni risposta. Per Almeida anche gli agenti che scrivono codice appartengono ancora all'era dell'assistenza.
2 · Compiacere
Addestrati a piacere a chi li valuta
Con l' il modello impara le risposte che le persone preferiscono. Il risultato promette più di quanto sa: l'eccesso di sicurezza viene dal metodo di addestramento.
3 · Parole
Troppe parole per dire sì
Per scegliere fra sette voci un chatbot scrive, ragiona e a volte divaga. Ogni parola costa tempo e denaro, e il programma deve poi interpretare il testo per capire la risposta.
4 · Priorità
La «lezione amara», corretta
Più calcolo non basta. L'ordine giusto per Almeida: prima il compito giusto, poi i dati, poi il calcolo. Da qui una terza strada di addestramento, calibrata, diversa da e .
Fonte: talk pre-lancio di Diogo Almeida. Sono tesi del produttore, senza misure a sostegno.
Due demo · 1 di 2
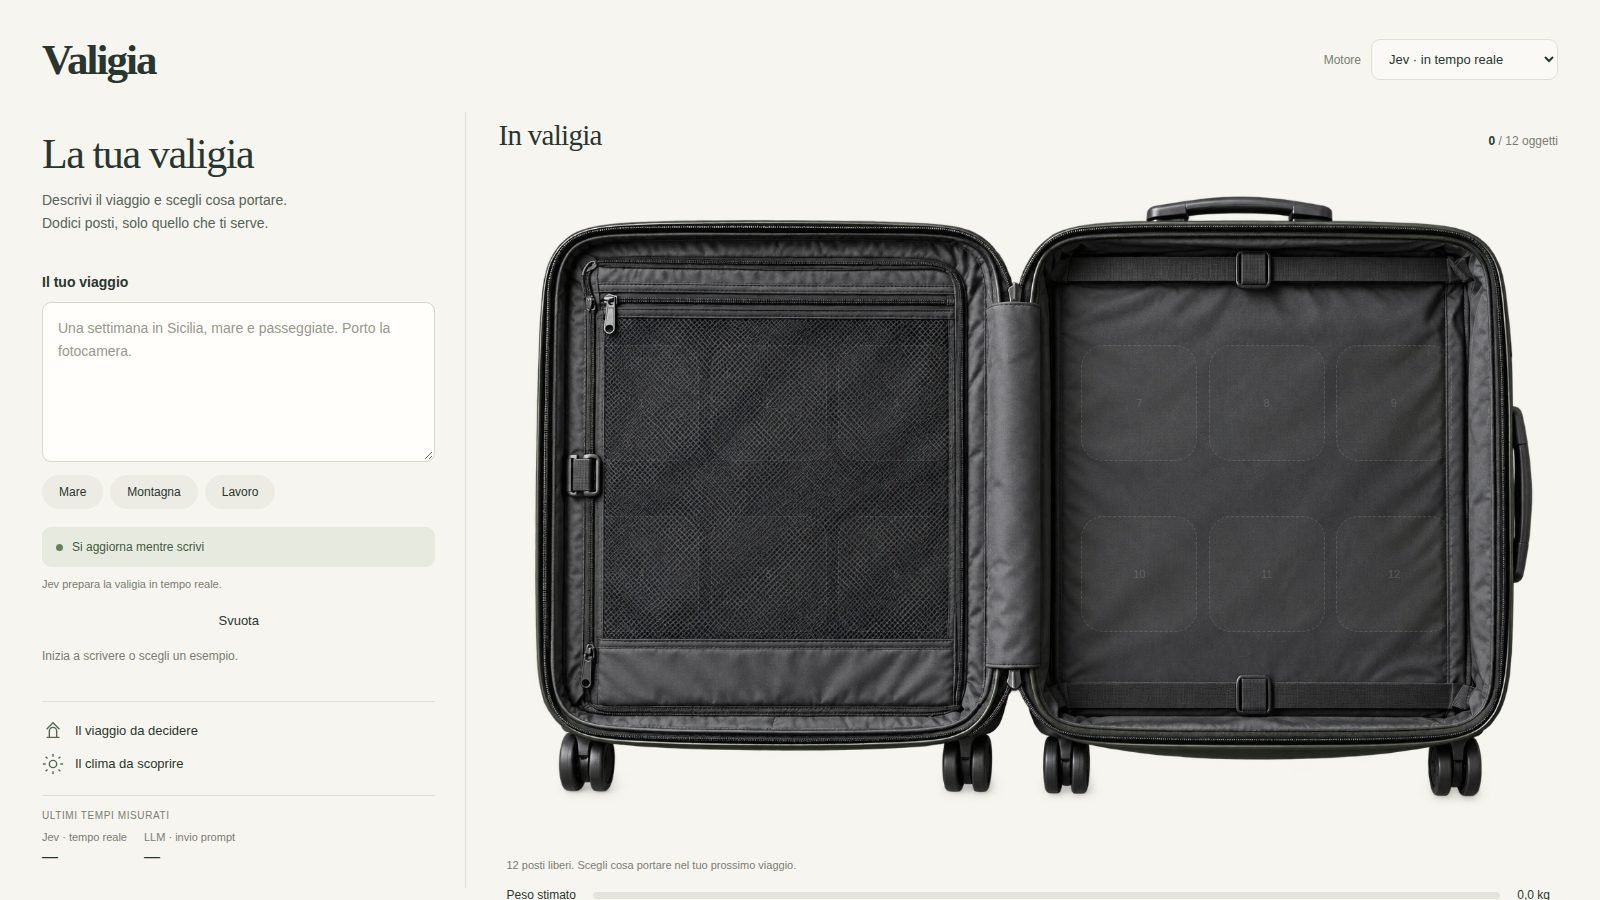
La valigia che si riempie mentre scrivi
Descrivi il viaggio: «weekend al mare in Liguria con due bambini».
Con Jev la valigia cambia a ogni parola: ogni modifica del testo è una nuova decisione.
Passa al motore LLM (DeepSeek 4.1 Flash): devi premere Invio e aspettare.
In basso a sinistra: gli ultimi tempi misurati dei due motori.
Dodici posti e un inventario chiuso: il modello sceglie gli oggetti, il software tiene il limite.
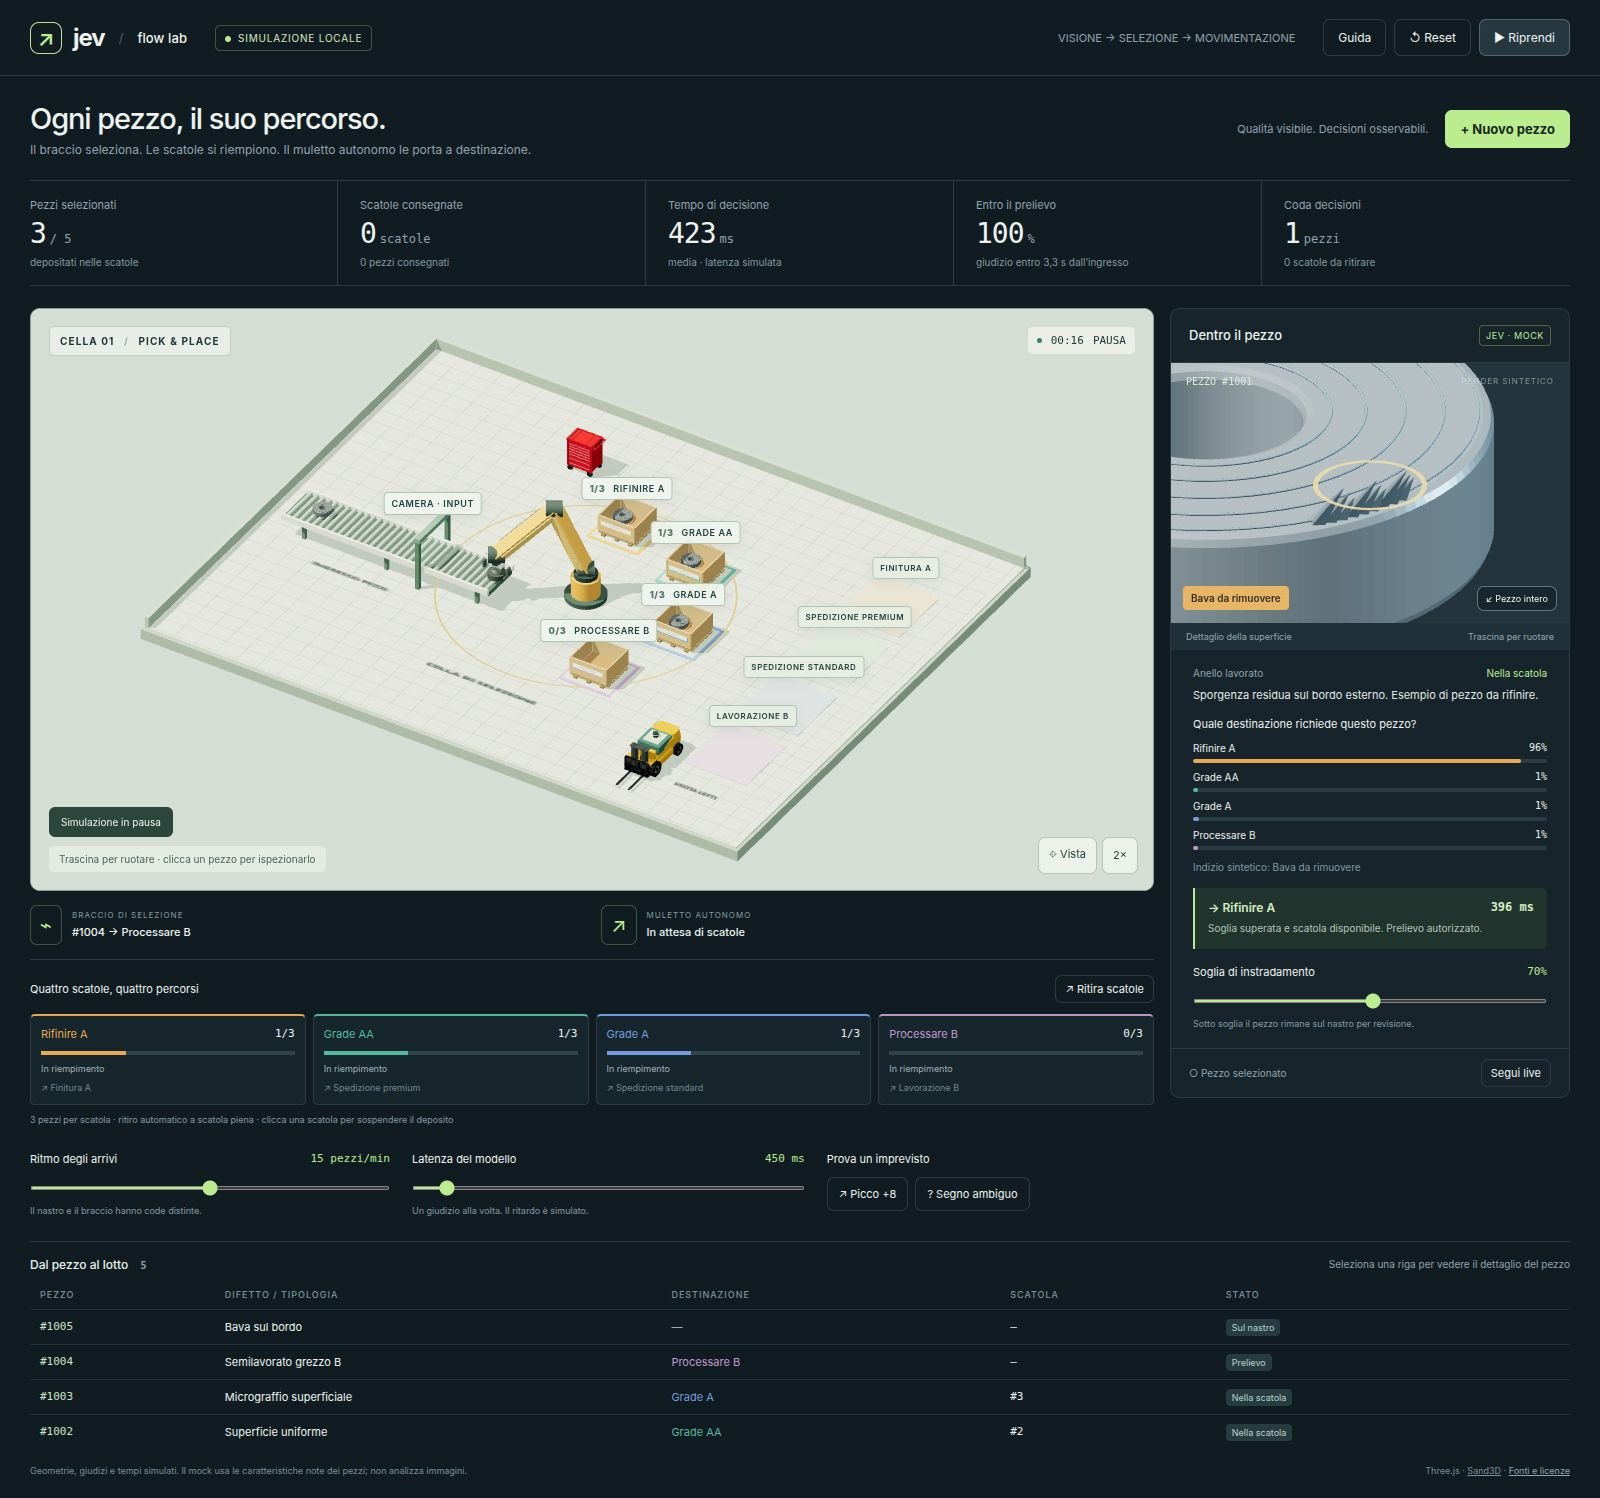
Il braccio preleva i pezzi dal nastro e li mette in quattro scatole: Rifinire A, Grade AA, Grade A, Processare B. Un muletto porta via le scatole piene.
Picco +8 e latenza a 4.000 ms: le decisioni arrivano tardi e il nastro aspetta.
Soglia al 99%: nessun pezzo è abbastanza sicuro, la linea si ferma.
Pezzo ambiguo: 53% di probabilità, sotto la soglia del 70%, resta fuori dalle scatole.
Simulazione: probabilità e latenze sono illustrative, nessuna chiamata a Jev.
La soluzione · prova in sala
Tocca a voi: costo bancario o altro costo?
Rispondete d'istinto, per alzata di mano. Il tempo parte quando compare la riga.
A che cosa serve: , un esempio reso anonimo.
La soluzione · due modi di pensare
Sistema 2 scrive, Sistema 1 sceglie
LLM · Sistema 2
«Analizzando la descrizione, si tratta probabilmente di una commissione applicata dalla banca per l'esecuzione del bonifico. Tuttavia, senza ulteriori informazioni sul contratto, non è possibile escludere che…»
Legge il contesto e assegna una probabilità a ogni risposta ammessa
Tempo
Millisecondi: Jev dichiara 70–500 ms
Uscita
Un valore tipizzato, pronto per il codice
Serve a
Classificare, instradare, verificare
I due sistemi vengono da Pensieri lenti e veloci di Daniel Kahneman. TypeSafe chiama i suoi modelli System One.
La soluzione · come si parla al modello
Un contesto, domande chiuse, probabilità
JSON in entrata · state + questions
JSON in uscita · answers (forma semplificata)
Confidence di una scelta fra n opzioni: (pmax − 1/n) / (1 − 1/n). Qui (0,88 − 1/3) / (2/3) = 0,82.
choice
Una fra opzioni definite. Quale squadra?
noul
Vero o falso, con probabilità. C'è un difetto visibile?
score
Livelli ordinati. Evidenza assente, debole, chiara, molto chiara.
box
Dove si trova nell'immagine, dove il modello lo supporta.
La soluzione · l'architettura
Il modello giudica, il software decide
Ingresso
Evidenza
Testo, foto, misure, un PDF già letto
→
Modello
Giudizi circoscritti
Una probabilità per ogni risposta ammessa
→
Codice
Regole leggibili
Soglie, tetti, eccezioni, autorizzazioni
→
Procede in automatico
Va a una persona
Servono altri dati
Una misura fuori tolleranza, un lotto senza codice, una firma mancante: sono condizioni che il programma verifica da solo. Il modello entra solo dove servono le parole o gli occhi.
TypeSafe stessa, il 3 novembre, in Don't call it a decision model: il modello interpreta l'evidenza, le regole del software stabiliscono l'esito.
Formula Finance · il nostro caso
I costi bancari, riga per riga
Dagli estratti conto trimestrali ricaviamo quanto un'azienda paga alla sua banca: canoni, commissioni, bolli, interessi. Sono migliaia di addebiti, e ogni banca li scrive a modo suo.
1 · codice
PDF dell'estratto
Riconosce banca, trimestre e tipo di documento
2 · codice
Lettura e quadratura
17 lettori di banca e uno generico; saldi al centesimo
3 · codice
Prefiltro
POS, F24, addebiti SDD, bonifici grandi: fuori subito
4 · decision model
Classificatore
Sceglie fra 7 voci, con la confidenza
5 · codice
Regole
Commissioni scritte nel testo, operazioni gemelle, tetti
6 · LLM
Qwen sui dubbi
Conferma, scarta o segnala, a blocchi di 50
codice deterministicodecision model, in ufficioLLM, solo per i casi dubbi
Simulazione nel browser con le voci, il prefiltro e le soglie vere della pipeline. Le probabilità sono di esempio, non escono dal modello. Movimenti inventati.
Formula Finance · il percorso
Da Jev a Kev: addestrato sui nostri estratti
12–14 ottobre · Jev via OpenRouter
Funziona: su 6 estratti di banche mai viste ne ritrova 5 fra l'89,5 e il 100% dei costi, in meno di un secondo e per un decimo di centesimo a estratto. Ma il servizio è negli Stati Uniti: per non far uscire i nomi il testo va mascherato, e col mascheramento sicuro sbaglia di 1.200 € su un conto. Abbandonato.
15 ottobre · Kev, seconda versione
Modello aperto con lo stesso contratto di Jev, addestrato su circa 9.000 addebiti di 30 clienti e servito in ufficio. Il testo resta in chiaro e non lascia la nostra rete.
26 ottobre · in staging
Il classificatore diventa un embedding con due piccole teste. Le regole dopo restano le stesse.
«È un costo?» risposta giusta su 686 addebiti di 6 banche mai viste in addestramento
Kev di base
19%
Kev, 1ª versione
93,9%
Kev, 2ª, int8
94,6%
050%100%
89,5%precisione
93 sper 686 righe, su una GPU
1,2 GBdi memoria video
Sviluppi futuri
1984: fantascienza.2026: un'API.
Sviluppi futuri · Gemini Decision 1 sul video
Le domande si scrivono, non si addestrano
Computer vision classica
Riconosce solo le cose su cui è stata addestrata: pedone, auto, semaforo. Una domanda nuova vuole migliaia di immagini etichettate e un nuovo addestramento. Che cosa fare lo decidono regole scritte a mano.
Decision model
La domanda si scrive nella richiesta, con le sue opzioni: una domanda nuova è una riga di testo. Giudica la scena intera, «devo rallentare?», non solo le cose, e dà una probabilità.
99domande a fotogramma
0,14 $per 13.780 risposte
Prova di AI HOODIE, non di Google. Video di guida: City Driving 4K Kraków, Relaxing Roads 4K, CC BY 3.0.
Sviluppi futuri · annunciato l'11 novembre
Decidere guardando e ascoltando
Gemini Decision 1 di Google riprende il contratto di Jev (noul, choice, score) e lo porta su ogni tipo di ingresso.
testoimmaginiaudiovideoPDF
256Ktoken di contesto
1.000domande in una richiesta
150–250 msdichiarati, dall'invio alla risposta
$0,10per milione di token in ingresso, 2,4 volte Jev
Che cosa diventa possibile
Controllo qualità sul video della linea, senza estrarre fotogrammi a mano.
Una telefonata al servizio clienti instradata dall'audio, senza trascriverla prima.
Un estratto conto scansionato giudicato direttamente come PDF.
Il braccio della demo con occhi veri al posto della simulazione.
Annunciato ieri: nessuna verifica indipendente. Come Jev, è un servizio fuori dall'Unione europea.
degli addebiti escono con regole Python, prima di qualsiasi modello.
Misura del 23 ottobre su 12.177 addebiti di 162 trimestri: nessuno dei 4.378 costi è stato scartato per errore.
# prefilter.py: operazioni che non sono mai costi della banca
ALWAYS = re.compile(r"^(?:sdd\b|pagamento pos|delega f24|giroconto|mutuo\b|stipendi\b|prelievo|...)", re.I)
TRANSFER_MIN = 100.0# nessuna commissione arriva a 100 €
Il prezzo dell'addestramento
105 estratti che quadrano, etichettati da un LLM e corretti a mano
Banche di prova tenute fuori, una GPU dedicata, conversione a int8
Calibrazione: per banche nuove la temperatura giusta è 3,9, e le soglie vanno ritarate
Se le parole cambiano poco, uno script fa gran parte del lavoro. Il modello serve dove la variabilità è davvero alta.
Aspetti critici · 2 di 2
Quattro cose da sapere prima di fidarsi
Il classificatore del proprio dominio spesso vince
In uno studio indipendente un classificatore addestrato sulle etichette del compito batte i decision model generici su quasi tutti i benchmark. Da noi: 19% senza addestramento, 94,6% dopo.
La confidence è una formula, non una garanzia
Dipende da come il modello è calibrato. Sul nostro test cambiare la temperatura da 1 a 3,9 sposta il totale dei costi di oltre 150 €: soglie e probabilità si tarano insieme.
Resiste al rumore, non al senso
Codici e numeri a caso non spostano il giudizio. Un testo ostile infilato nel contesto sì: quello che entra nello state va controllato.
Dove vanno i dati?
Jev e Gemini sono servizi fuori dall'Unione europea. Per gli estratti conto dei clienti abbiamo scelto un modello che gira in ufficio.
Una risposta nel formato giusto non è per forza una risposta giusta.
In sintesi
Quando conviene un decision model
Sì
Un giudizio circoscritto, ripetuto migliaia di volte
Categorie chiuse che si sanno descrivere a parole
Serve una risposta mentre il processo scorre
Un errore costa poco, oppure il dubbio va a una persona
No
Strategie in più passi: un buon giudizio locale non è una buona strategia
Un numero che si calcola esattamente dai dati
Decisioni critiche senza nessuna revisione
Testi che variano poco: basta uno script
costo per caso = inferenza + preparazione + quota in revisione × costo della revisione + costo atteso degli errori
Il passo successivo · embedding · 1 di 2
Ogni riga è un punto: i costi bancari stanno sulla montagna
costo bancarioin revisionealtro costo
trascina per ruotare · rotella per lo zoom · clic su un punto
La vista 3D ha bisogno della connessione per caricare la libreria grafica.
Mappa illustrativa: un embedding ha centinaia di dimensioni, qui ne vedete due. L'altezza è la probabilità di costo data dalla prima testa, ogni vetta è una voce. Posizioni simulate nel browser, righe inventate.
Il passo successivo · embedding · 2 di 2
Per la velocità: tutto in un colpo
Decision model · una richiesta per testo
Ogni richiesta porta la riga, la domanda e i sette criteri. Il modello rilegge le istruzioni ogni volta.
0richieste0 KBistruzioni ripetute
Embedding · una sola richiesta
Tutti i testi unici partono insieme e tornano come vettori. Le categorie stanno in due regressioni logistiche, calcolate sul nostro server.
0richieste0 KBistruzioni ripetute
Testi uguali a meno delle cifre contano una volta: 5.550 addebiti diventano 773 testi (misura del 24 ottobre). Un embedding multimodale porta lo stesso schema su immagini e audio. Animazione dimostrativa: conta richieste e byte, non misura i tempi.
Community Night · 12 novembre 2026 · Fabbrica in Pedavena, Brescia
 Community Night · 12 novembre 2026 · Fabbrica in Pedavena, Brescia