Come leggere i benchmark dell’intelligenza artificiale: dagli esami di matematica ai repository da riparare, dalle decisioni di Jev alle immagini e ai mondi 3D. Come funzionano i test, come si assegnano i punti e quanto di quel numero arriva davvero nel tuo lavoro.
Un modello prende il 68%. Lo stesso modello prende l’88%. Non è diventato più grande, non ha ricevuto un nuovo addestramento, non è cambiata la versione dei pesi. È cambiato il software che lo fa lavorare.
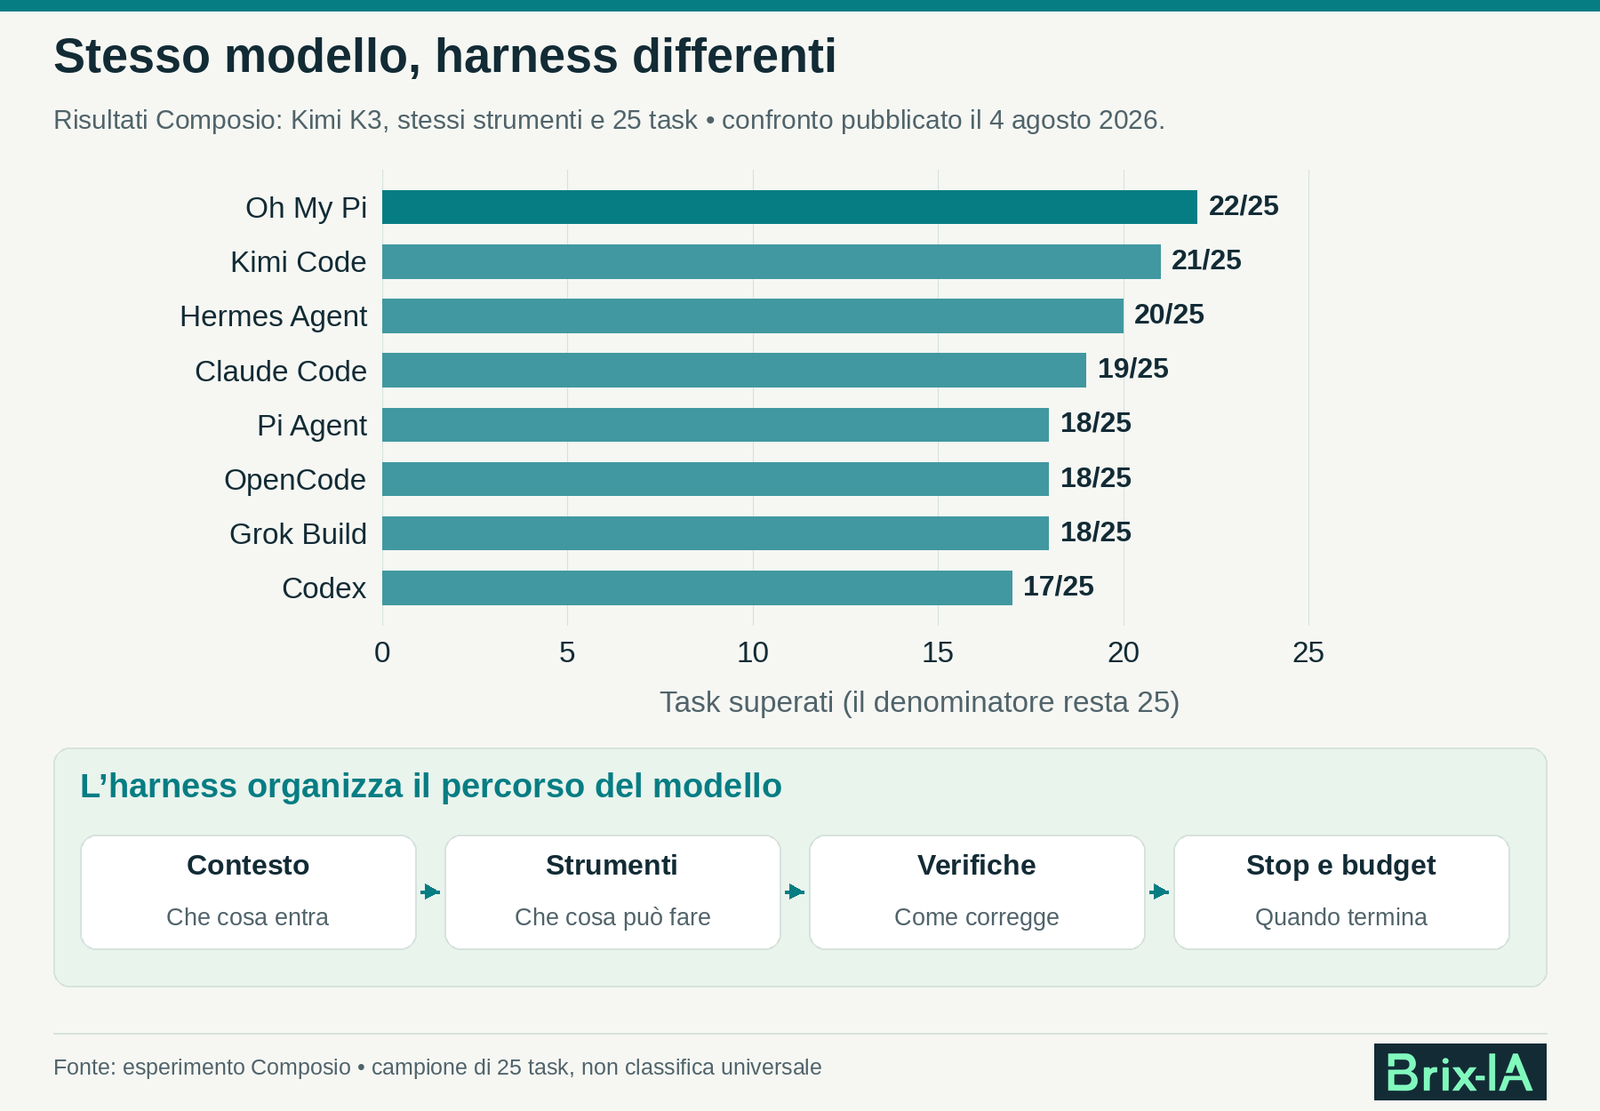
Nel confronto di Composio su Kimi K3, otto harness affrontano gli stessi 25 compiti con gli stessi strumenti. I risultati vanno da 17 a 22 successi. Cinque lavori portati a termine in più: abbastanza per cambiare la giornata di chi usa l’agente, e per spostare di venti punti una classifica. Esperimento Composio.
Ora pensa alle tabelle che accompagnano ogni nuovo modello. Celle verdi, record, percentuali con un decimale in più. GPQA, SWE-bench, HLE, Terminal-Bench. Tutto sembra suggerire un voto unico all’intelligenza.
Per leggere quelle tabelle serve sapere che cosa c’è dentro ogni riga. Quale compito è stato assegnato. Chi lo ha corretto. Quanti tentativi erano disponibili. E cosa poteva usare il sistema mentre lavorava.
Un benchmark AI è un esame con una materia, un regolamento e un correttore. Il voto diventa utile quando sai quali sono. Partiamo da lì, poi allarghiamo lo sguardo fino alle immagini, alle ricostruzioni da fotografie e ai mondi generati. Gli esempi semplificati sono costruiti per spiegare i test; i risultati sperimentali sono accompagnati dalle loro fonti.
1. Breve storia dei benchmark LLM: perché servono nuovi test
Nel 2018, quando arrivò GLUE, gran parte della valutazione del linguaggio ruotava attorno a compiti circoscritti. Una recensione è positiva? Due frasi dicono la stessa cosa? Questa conclusione segue dalla premessa? GLUE riunì più prove in una suite. SuperGLUE, nel 2019, alzò la difficoltà. GLUE, SuperGLUE.
Il meccanismo era già visibile: il test che ieri separava bene i modelli oggi li trova ammassati vicino al soffitto. Serve un esame più selettivo.
Con i modelli generativi il programma si è allargato. Cultura accademica, problemi matematici, funzioni da scrivere. Poi il lavoro fuori dalla conversazione: correggere un progetto, cercare sul web, aprire un’applicazione. Il percorso dei benchmark racconta questa evoluzione, dalla risposta al compito completato. Questa evoluzione è approfondita nel nostro articolo sul passaggio dai prompt agli agenti.
C’è però un secondo problema. L’esame viene pubblicato, le soluzioni circolano, qualcuno scrive un tutorial. Il materiale entra nello stesso web da cui provengono molti dati di addestramento. Nel frattempo, i laboratori lavorano per migliorare proprio le capacità che verranno misurate.
Allenare un modello su problemi simili può insegnargli un metodo. Ottimizzare a lungo un punteggio può renderlo particolarmente bravo in quel formato. Fargli incontrare domanda e risposta del test introduce contaminazione. Tre situazioni diverse, che in una tabella finale possono produrre lo stesso numero. Un caso da leggere in questo contesto è il nostro approfondimento su MiniMax M2.7 e il miglioramento dei modelli.
La somiglianza con la scuola è evidente. Studiare algebra prepara all’esame. Memorizzare il compito di domani prepara a quel compito. Per sapere quale delle due cose è successa, devi cambiare le domande.
OpenAI ha documentato su SWE-bench Verified casi di recupero di dettagli dei problemi e delle patch di riferimento. È un motivo concreto per chiedere come venga protetto il test e quanto il suo risultato dipenda dall’esposizione precedente. Audit di SWE-bench Verified.
Da qui nascono dataset riservati, prove nuove e benchmark aggiornati. LiveBench, per esempio, usa informazioni recenti e risposte confrontabili con riferimenti oggettivi. Paper LiveBench.
La manutenzione diventa parte del mestiere. Un benchmark statico può ancora essere utile per modelli che faticano a risolverlo; perde capacità di distinguere quelli che lo superano quasi sempre. E aggiornare le domande riduce un rischio, senza cancellare per sempre la possibilità che l’esame entri nell’addestramento successivo.
2. Come si calcolano i punteggi dei benchmark AI
Se il sistema risolve 80 problemi su 100, prende l’80%. Semplice. Finché non chiedi che cosa significhi «risolve».
Basta indovinare la risposta finale? Deve passare ogni test? Può provare dieci volte? Il voto considera il file consegnato o quello che il modello racconta di aver fatto?
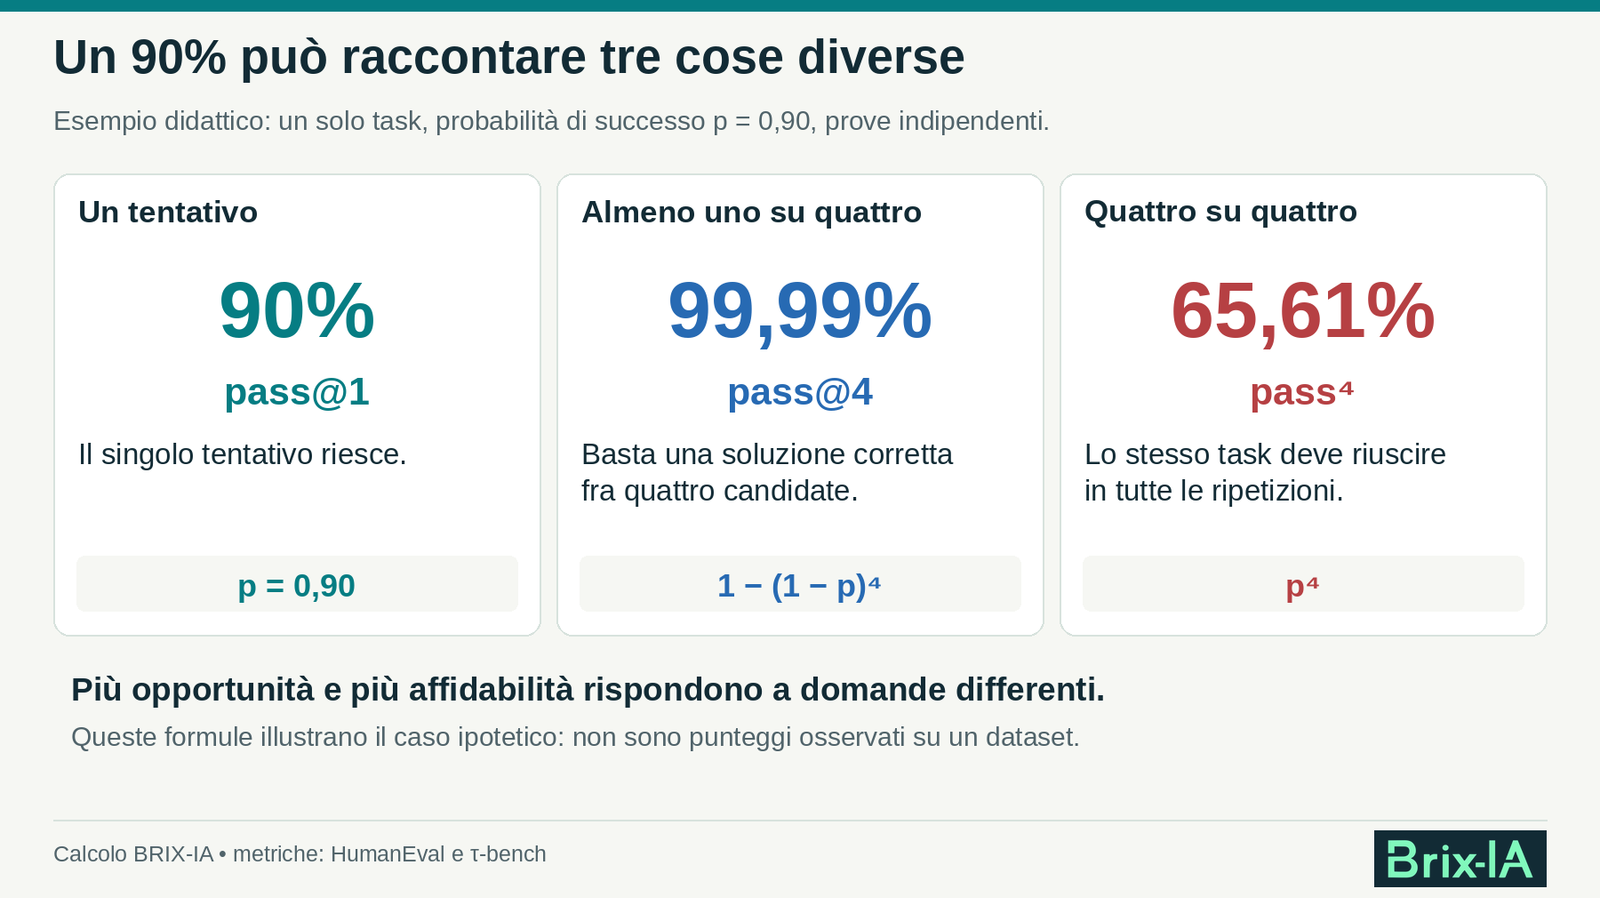
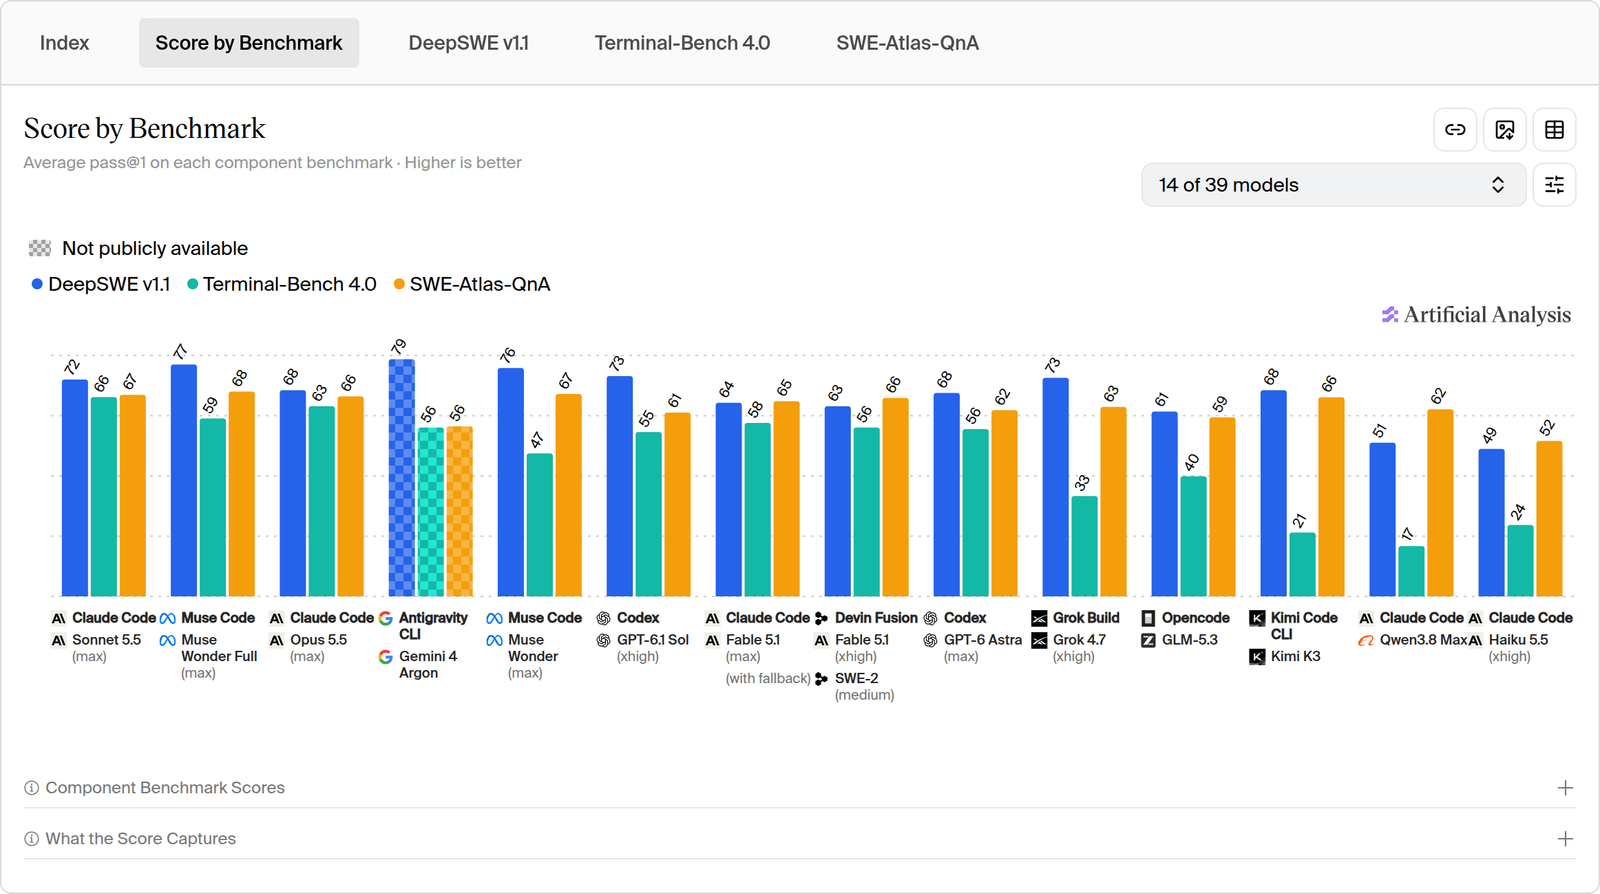
Nel codice trovi spesso pass@1: successo di un singolo tentativo. I ricercatori possono stimarlo ripetendo la valutazione molte volte. Il budget del tentativo e il numero di misure sono due informazioni distinte.
pass@k chiede se almeno una fra k candidate supera la verifica. Generare più soluzioni aumenta le possibilità, ma resta da scegliere quella corretta quando il correttore del benchmark non è a disposizione. pass^k guarda alla consistenza: tutte le k prove dello stesso task devono riuscire. HumanEval e pass@k, τ-bench e pass^k.
Facciamo il conto su un compito ipotetico. Il sistema riesce con probabilità del 90%. Assumendo prove indipendenti, almeno un successo in quattro tentativi ha probabilità 99,99%. Quattro successi su quattro: 65,61%. Il primo numero parla delle opportunità; il secondo dell’affidabilità. Per un processo che deve funzionare ogni giorno, la differenza pesa.
Esistono poi rating, distanze e indici compositi. Un Elo di 1.800 non significa 180% di correttezza. Una distanza più bassa può essere un risultato migliore.
Anche le unità contano. Dal 60% al 70% sono dieci punti percentuali, un aumento relativo di circa il 16,7%. Su cento task sono dieci successi in più. Su dieci task, uno. I decimali stampati nella tabella non sostituiscono il numero delle prove e la loro variabilità.
3. Principali tipologie di benchmark AI e LLM
Nelle schede consultate di Anthropic, OpenAI, DeepSeek, Z.ai e Moonshot ricorrono terminale, coding agentico, ragionamento, strumenti e lavoro professionale. Le combinazioni cambiano: ogni produttore mette in evidenza alcune capacità e usa propri protocolli per misurarle. Anthropic, OpenAI, DeepSeek, Z.ai, Moonshot.
È una selezione dei nomi che incontriamo in quelle schede, insieme ad alcuni riferimenti storici. Anche scegliere quali righe pubblicare contribuisce al ritratto del modello.
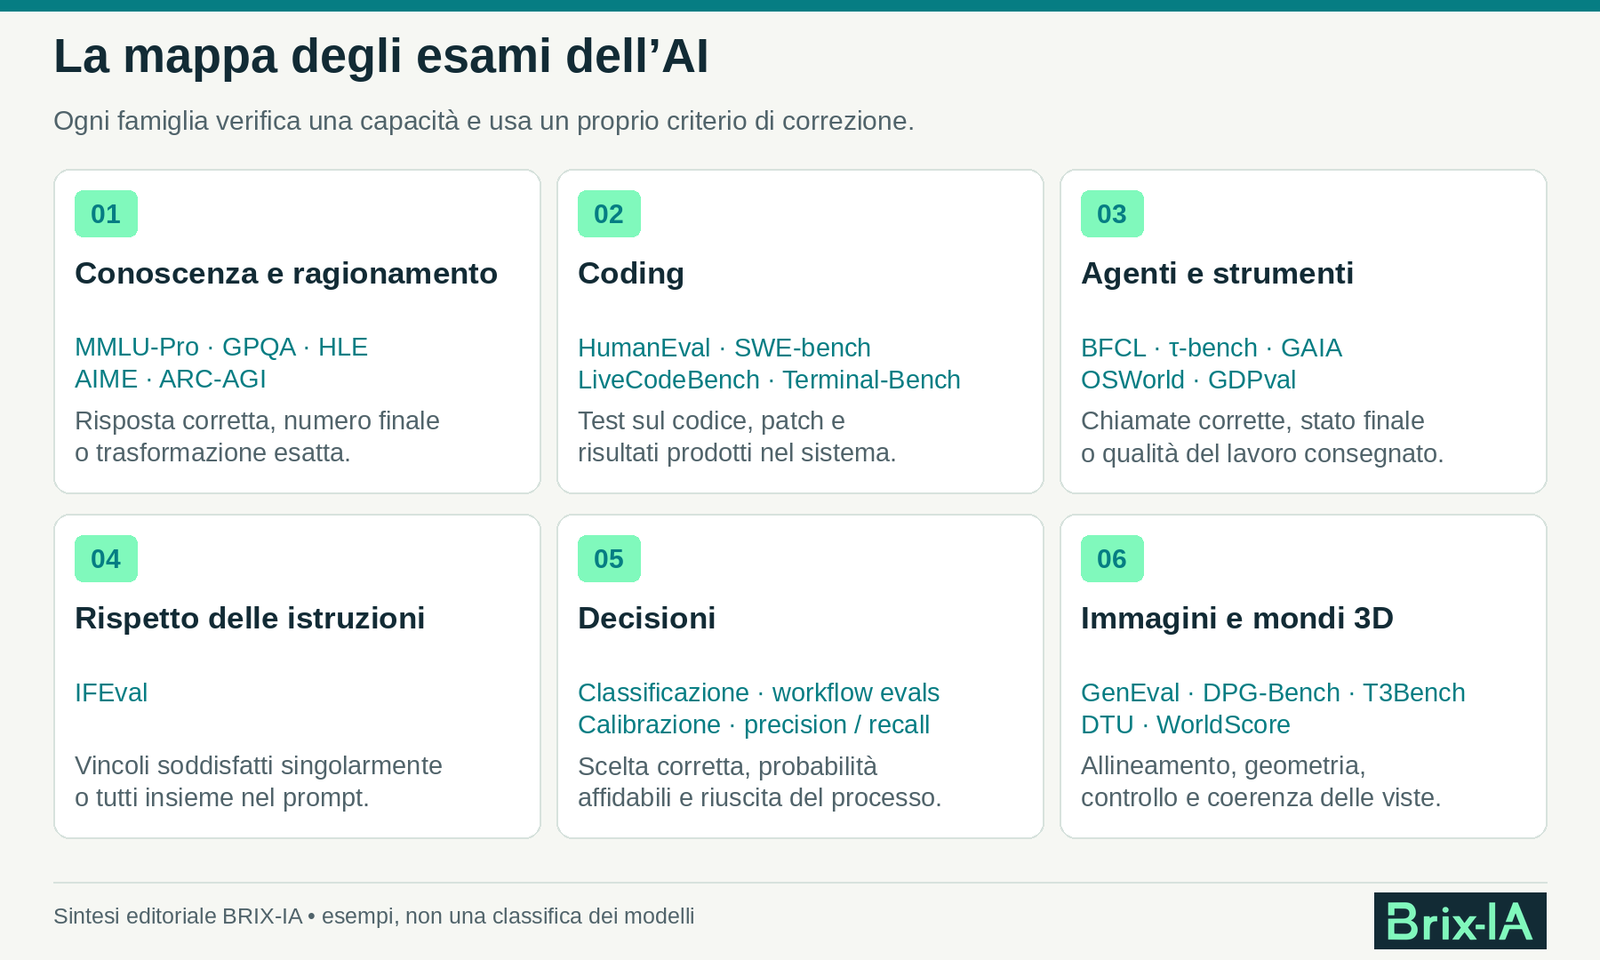
4. Conoscenza e ragionamento: i test di matematica e scienza
MMLU e MMLU-Pro: conoscenza e domande a scelta multipla
MMLU copre 57 ambiti accademici. Una domanda di economia, quattro interpretazioni possibili, una scelta corretta. Il punteggio misura l’accuratezza, con l’aggregazione prevista dal protocollo. Paper MMLU.
MMLU-Pro aumenta la difficoltà e porta le alternative da quattro a dieci. Indovinare diventa meno conveniente; alcune scorciatoie diventano meno efficaci. Progetto MMLU-Pro.
Sono prove utili per sondare conoscenza e ragionamento dentro un formato controllato. La distanza dal lavoro resta visibile: nella realtà le alternative spesso devi costruirle tu, e prima ancora devi capire quali informazioni mancano.
GPQA Diamond: domande di ragionamento scientifico
GPQA propone quesiti di biologia, chimica e fisica. Diamond contiene 198 domande, mentre il main set ne contiene 448. Confondere i due significa cambiare esame conservando il nome. Paper GPQA.
Immagina un equilibrio chimico descritto con precisione e quattro risposte plausibili su come reagirà a una variazione di temperatura e pressione. Il modello sceglie. Il correttore conta le risposte giuste.
L’intento «Google-proof» è rendere insufficiente una ricerca superficiale. Le comparazioni con esperti umani vanno lette sul subset e sulle condizioni della prova. Un risultato alto su quelle domande dimostra una prestazione su quelle domande; la capacità di fare ricerca richiede altre verifiche.
GSM8K e AIME: problemi di matematica e risposte esatte
GSM8K usa problemi matematici in linguaggio naturale: quantità, acquisti, tempi, più passaggi di calcolo. Si estrae e verifica il risultato finale. Dataset GSM8K.
AIME viene dalla matematica competitiva: 15 problemi per prova, con risposte intere fra 0 e 999. Nelle valutazioni AI servono anno, prova e numero di campionamenti. Formato MAA.
Pensa a un problema che chiede quante disposizioni rispettano una serie di vincoli. La risposta attesa è 126. Il modello scrive una pagina brillante e conclude 125. Punto perso.
La pulizia della correzione è un vantaggio. Il suo confine è altrettanto chiaro: il numero finale, da solo, non racconta la qualità di una dimostrazione o di una collaborazione con un matematico.
Humanity’s Last Exam (HLE): domande specialistiche e accuratezza
Humanity’s Last Exam, HLE, allarga l’esame a molte discipline e a domande specialistiche. La versione originale pubblica finalizzata nel 2025 comprende 2.500 quesiti, alcuni con immagini. Subset e aggiornamenti successivi richiedono un’etichetta precisa. Progetto HLE.
Il formato può chiedere un numero dopo aver riconosciuto un dettaglio anatomico, oppure una breve espressione specialistica. La risposta viene confrontata con il riferimento; i protocolli usano anche giudici per gestire varianti della formulazione. Il voto principale è l’accuratezza. Codice HLE.
Aggiungi ricerca web e codice, e cambi le condizioni dell’esame. «Con strumenti» deve restare accanto al punteggio. Il titolo suggerisce una prova definitiva; il risultato riguarda un insieme di quesiti verificabili, che lascia fuori buona parte dell’esplorazione scientifica aperta.
ARC-AGI: ragionamento sulle griglie e prove interattive
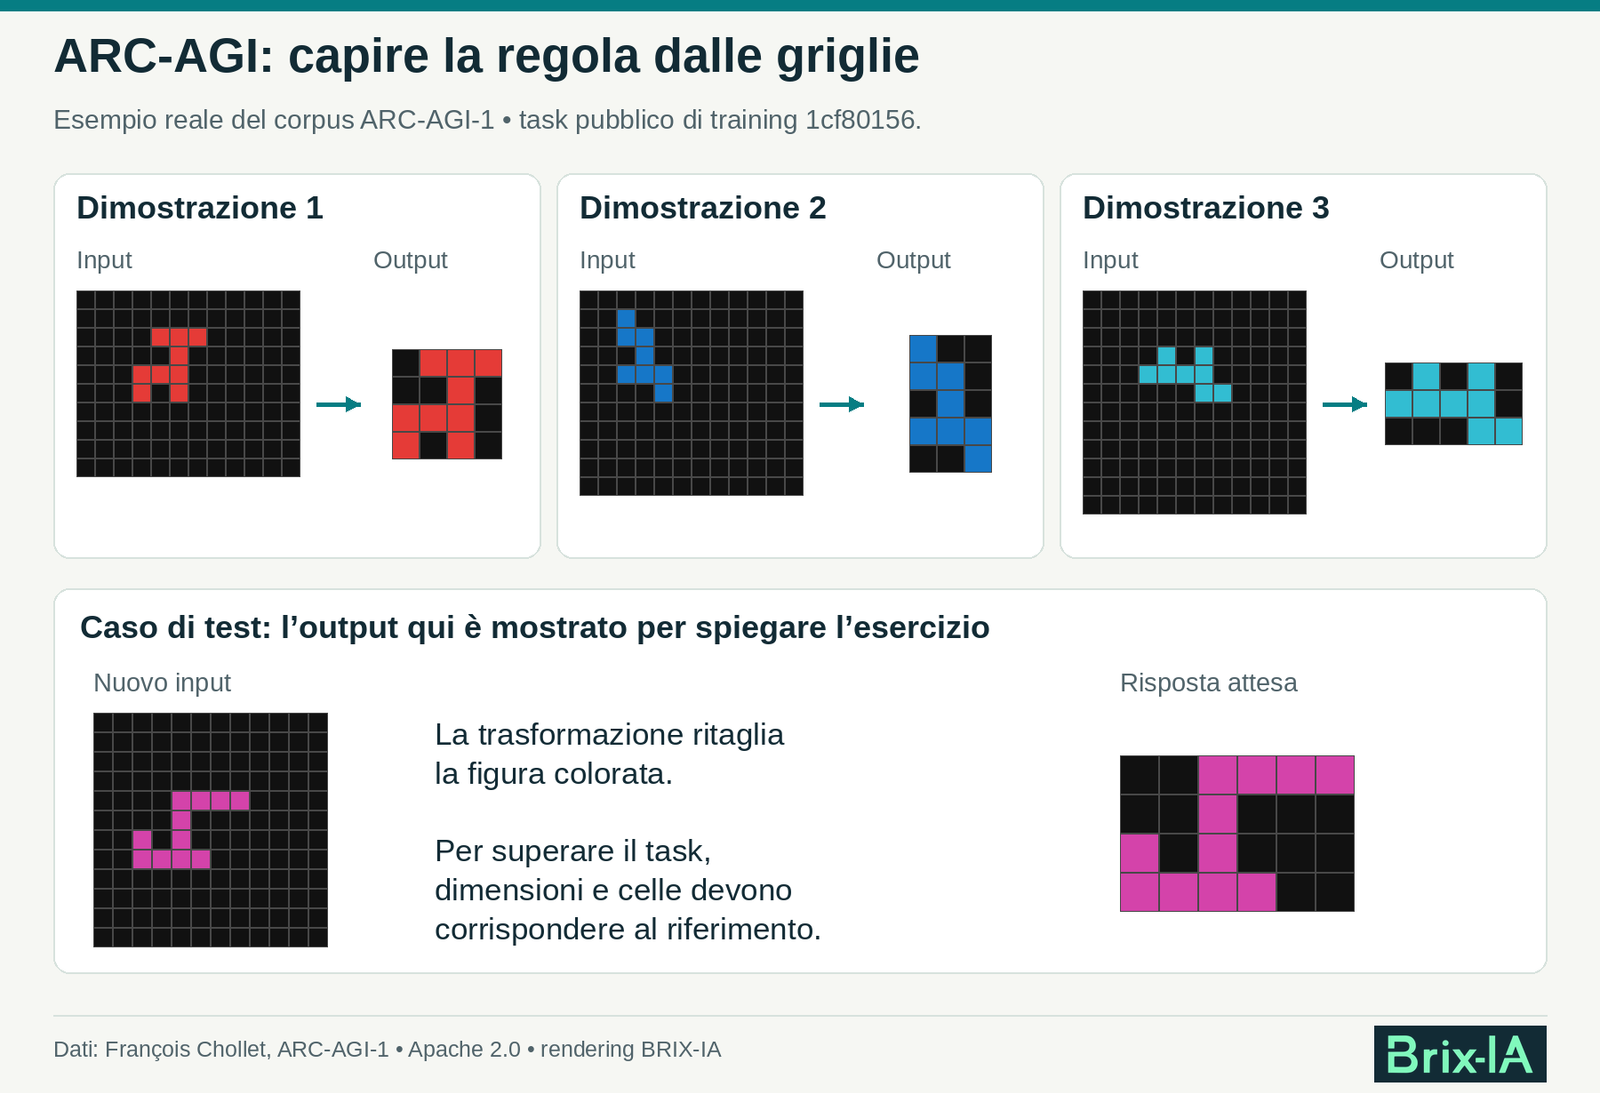
In ARC-AGI le griglie colorate mostrano trasformazioni da inferire. Una forma viene spostata verso un bordo, per esempio, e devi capire come applicare la regola a un caso nuovo. Nelle versioni a griglie conta l’esattezza dell’output, dentro il protocollo dei tentativi consentiti. ARC-AGI-2.
ARC-AGI-3 introduce ambienti interattivi: esplorare, scoprire regole, completare livelli. Il punteggio considera le azioni rispetto a una baseline umana. Nel calcolo per livello, usare il doppio delle azioni porta il rapporto quadratico al 25%, prima dei limiti e dell’aggregazione. Metodologia ARC-AGI-3.
Arrivare alla fine conta. Conta anche quanta esplorazione è servita. È un altro modo in cui una percentuale può raccontare qualcosa di più specifico del semplice «ci è riuscito».
5. Benchmark di coding: dalla funzione al repository
Scrivere una funzione è un buon punto di partenza. Poi arriva il repository: codice altrui, dipendenze, convenzioni, test e una modifica che deve convivere con tutto il resto. I benchmark del coding percorrono questa distanza.
HumanEval: codice Python verificato con test automatici
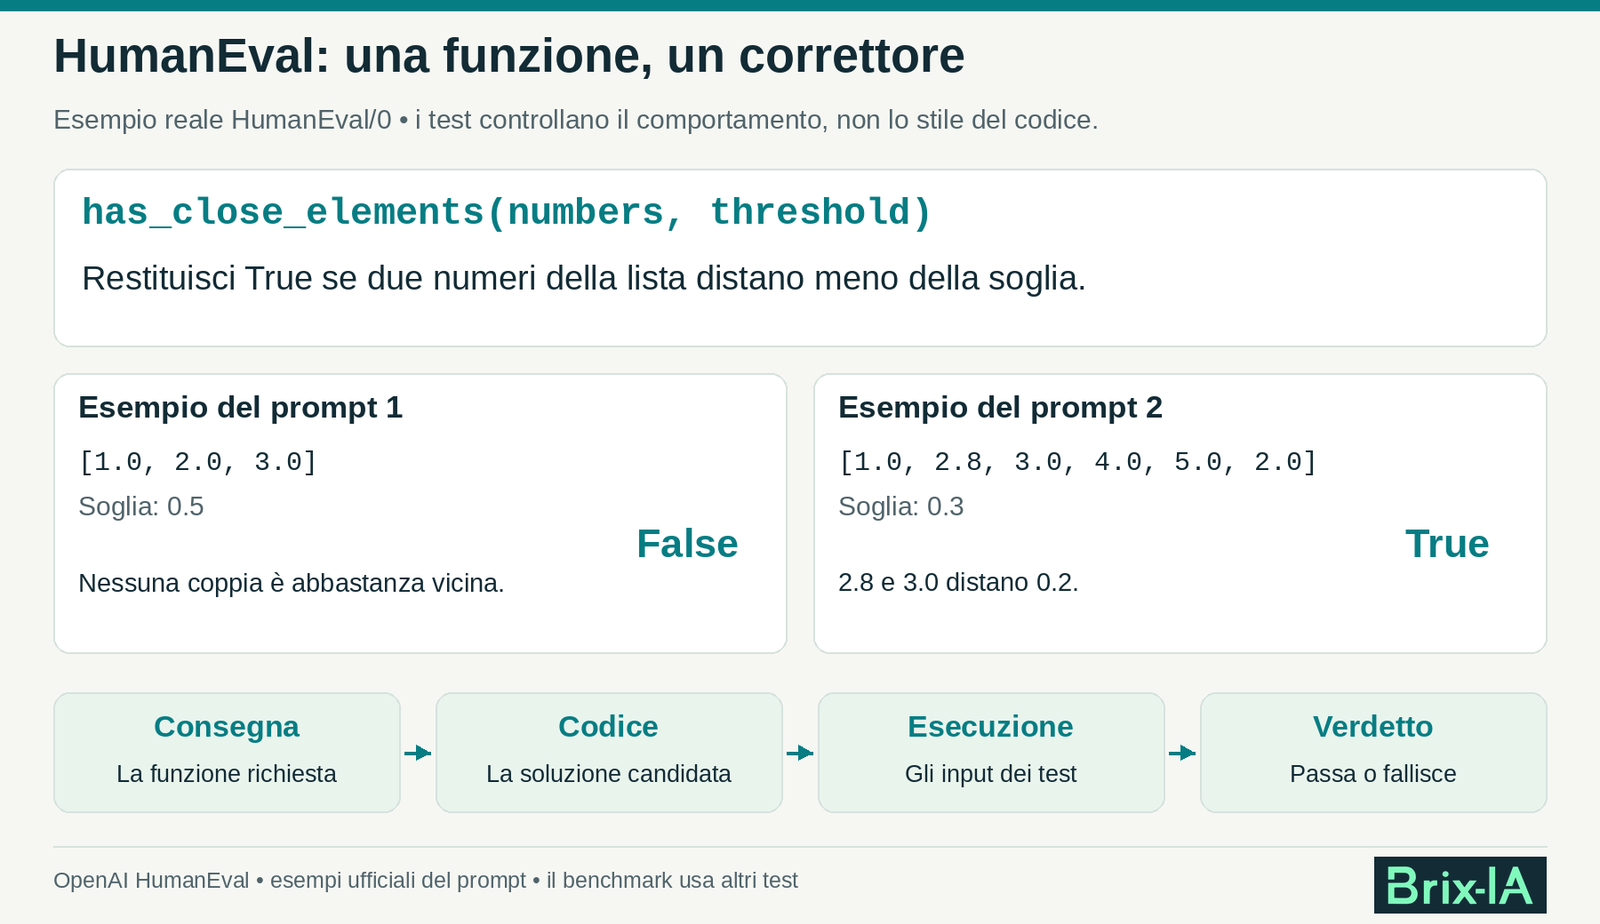
HumanEval raccoglie 164 problemi con funzioni da completare e test sul comportamento. La richiesta potrebbe essere restituire gli elementi che compaiono esattamente due volte in una lista. Il modello scrive il codice; il correttore lo esegue su casi diversi. Paper HumanEval.
Due implementazioni possono essere diverse e passare entrambe. Conta la correttezza funzionale, misurata con metriche come pass@1 e pass@k. Il test verifica una capacità importante su problemi circoscritti. Un progetto aggiunge difficoltà che la singola funzione non incontra.
LiveCodeBench: programmazione con problemi recenti
LiveCodeBench raccoglie problemi di competizioni pubblicati in date note. Con un cutoff di addestramento dichiarato, si può scegliere una finestra successiva. Il progetto considera generazione, esecuzione, autoriparazione e previsione degli output. Progetto LiveCodeBench.
Il programma deve rispettare i vincoli del problema. Passare l’esempio con dieci elementi e andare in timeout su un milione può costare il task. Il punteggio deriva dai test del protocollo usato.
La finestra temporale va conservata accanto al risultato. Due periodi possono contenere problemi diversi e cambiare l’ordine dei modelli. Il nome «Live» indica un modo di mantenere il test; per valutare la contaminazione serve sapere quali problemi sono stati effettivamente eseguiti.
SWE-bench: correggere bug e verificare patch nei repository
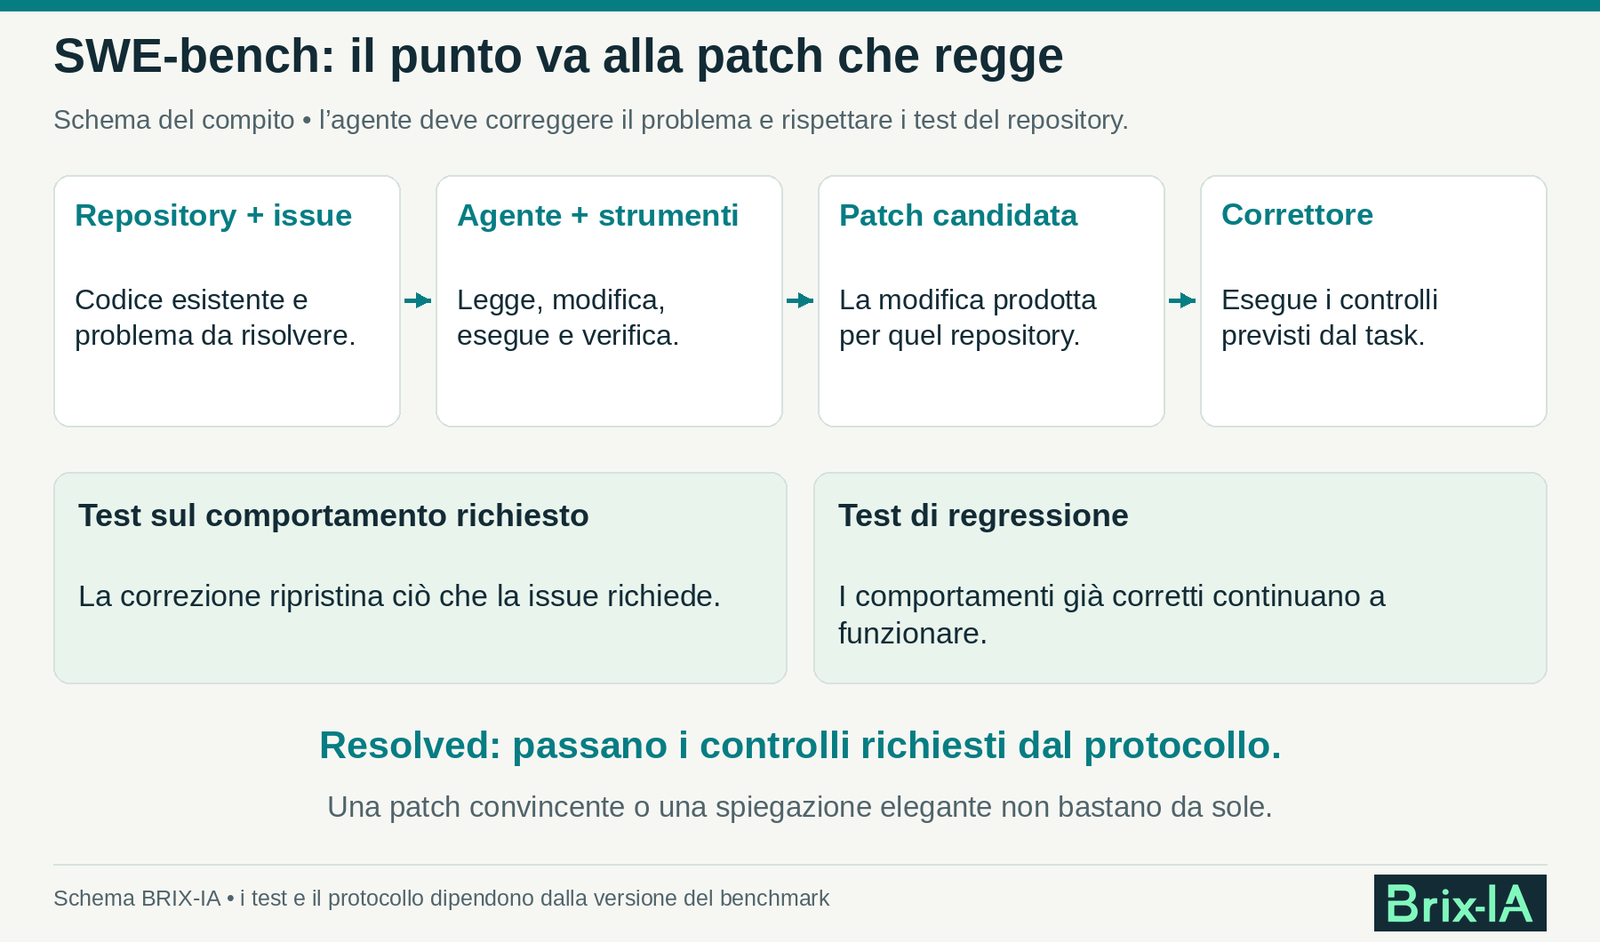
Una issue descrive un errore nelle date. Ricevi il repository, trovi dove nasce il problema, modifichi il codice e consegni una patch. La correzione deve funzionare e lasciare intatto ciò che funzionava prima.
Questo è il genere di lavoro misurato da SWE-bench. I test verificano il comportamento corretto e le regressioni. La metrica «resolved» conta i task risolti: passare nove controlli su dieci può comunque far perdere il task intero. Progetto SWE-bench.
Verified è un subset revisionato da persone. SWE-Bench Pro è un progetto distinto, con problemi e protocolli differenti. Uno scarto fra i punteggi dei due può dipendere da più variabili, compresa la difficoltà: non è una misura diretta di quanti punti abbia regalato la contaminazione.
E il correttore può avere difetti. Nell’audit OpenAI, 138 problemi erano stati selezionati perché o3 faticava a risolverli con continuità; il 59,4% presentava problemi materiali nei test o nelle descrizioni. La percentuale riguarda quel campione selezionato. Anche Pro è stato oggetto di nuove proposte di revisione. Audit OpenAI, SWE-Bench Pro Verified.
Un test automatico dà un verdetto ripetibile. Per capire se il verdetto è sensato bisogna verificare anche il test.
DeepSWE: coding agentico su problemi originali
DeepSWE compare nelle schede consultate di DeepSeek, GLM e Kimi. Il progetto usa 113 task originali di ingegneria del software. Nella versione 1.1 la patch viene applicata e verificata in un contenitore pulito, separato dall’ambiente dell’agente. Il risultato principale distingue successi e fallimenti, con dettagli dei singoli controlli. Repository DeepSWE.
L’obiettivo è controllare il comportamento richiesto dalla consegna. Il codice prodotto può avere una struttura diversa dalla soluzione di riferimento, purché soddisfi quei criteri.
Terminal-Bench: compiti per agenti nel terminale
Hai un insieme di file danneggiati. Devi ricostruire i dati, trasformarli e salvare un output preciso. Servono shell, programmi, verifiche e magari più tentativi. Terminal-Bench misura lavori di questo tipo, oltre a configurazione di strumenti e problemi di sistema.
Il task viene giudicato sull’esito prodotto. Il modello può avere capito il problema e fallire perché l’output è incompleto o è stato salvato nel posto sbagliato.
La release 4.0 corregge task, ne rimuove altri e modifica risorse e timeout. Cambiare versione può richiedere una nuova esecuzione: confrontare direttamente due percentuali di versioni diverse perde il riferimento comune. Release Terminal-Bench 4.0.
6. Instruction following: IFEval e il rispetto delle istruzioni
Chiedi una risposta con tre vincoli. Il modello ne rispetta due, aggiunge una spiegazione elegante e ti lascia un output che il tuo programma rifiuta. Per la conversazione è quasi giusto. Per l’integrazione può essere inutilizzabile.
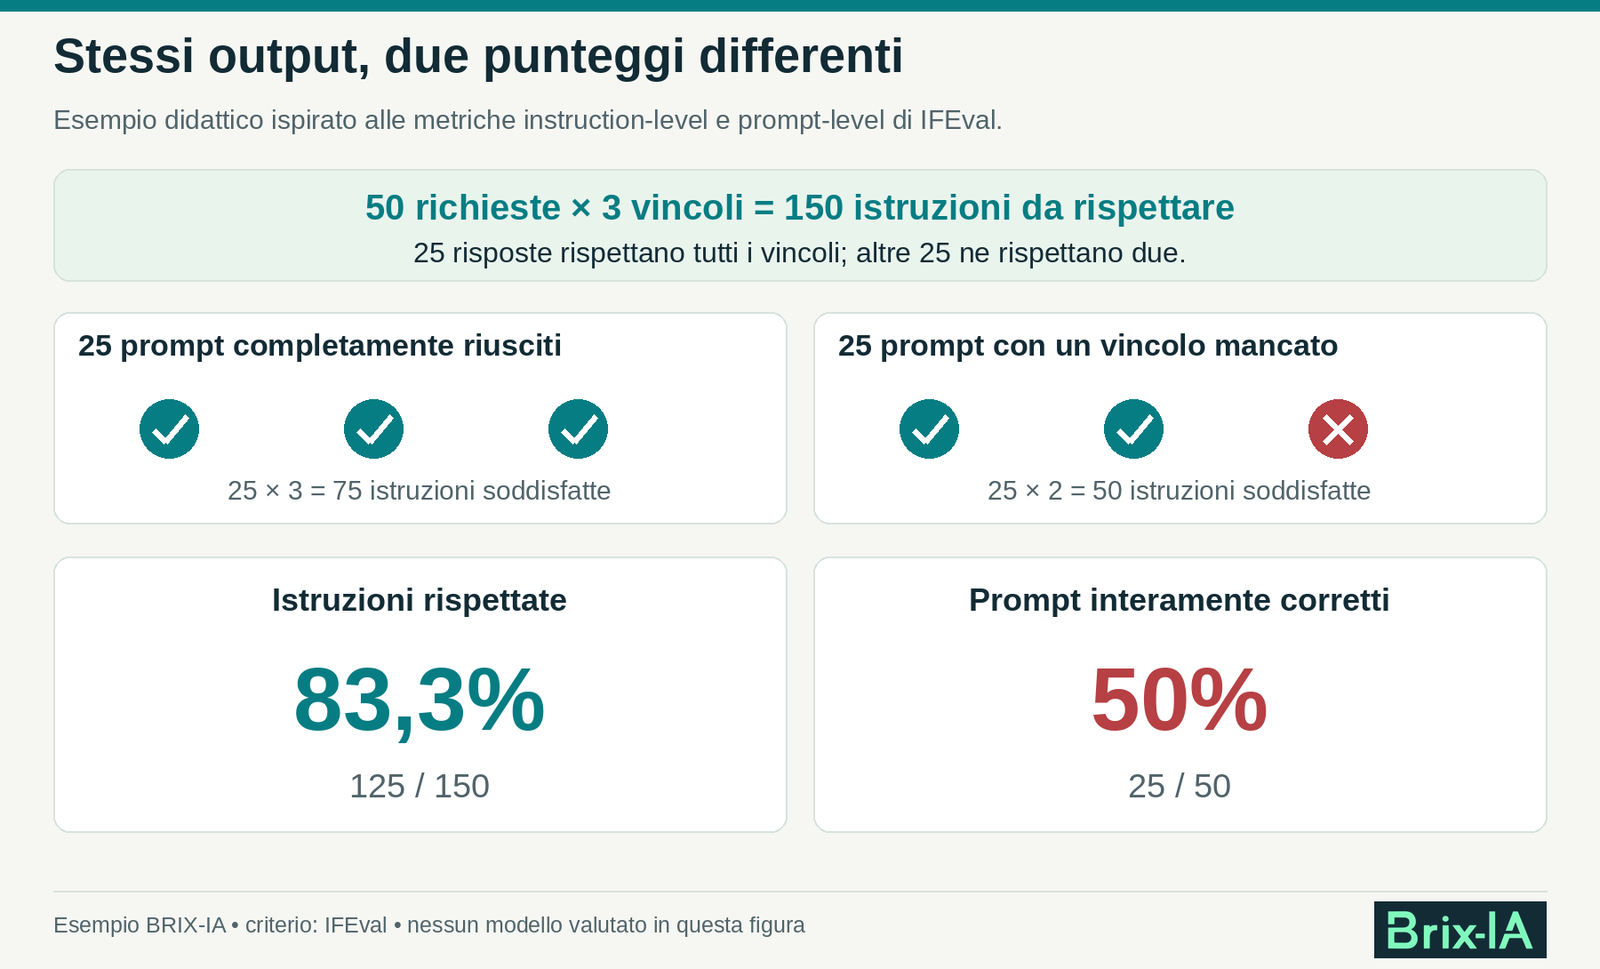
IFEval misura istruzioni verificabili automaticamente: lunghezza, parole obbligatorie, formati e altri vincoli. Distingue il rispetto di ogni istruzione da quello del prompt completo. La seconda misura richiede che tutti i vincoli siano soddisfatti. Strict e loose trattano diversamente alcune variazioni della risposta. Paper IFEval, correttore ufficiale.
Facciamo il conto. Cinquanta richieste, tre vincoli ciascuna. Venticinque risposte li rispettano tutti; le altre ne rispettano due. Le istruzioni soddisfatte sono 125 su 150: 83,3%. I prompt completamente riusciti sono 25 su 50: 50%.
Stessi output, due numeri legittimi. La colonna scelta cambia la lettura.
Resta da controllare la sostanza. Un JSON perfetto può contenere un importo sbagliato. Il test sul formato misura il formato; la correttezza del contenuto ha bisogno del suo criterio.
7. Benchmark agentici: strumenti, azioni e lavoro completato
Quando l’AI usa strumenti, prenota, modifica, salva e cerca, il risultato esce dal testo. La valutazione deve seguirlo. Per vedere come questo ciclo prende forma in un prodotto, si può partire dalla nostra guida a OpenClaw per principianti.
BFCL: function calling, scelta degli strumenti e argomenti
Devi cercare un volo per una certa data. Il sistema seleziona lo strumento giusto, indica partenza e arrivo e passa valori nel formato previsto. Una città invertita è un errore anche se la chiamata sembra impeccabile.
BFCL, Berkeley Function Calling Leaderboard, valuta questa capacità. La metodologia usa controlli strutturali su funzione e parametri, e verifiche tramite esecuzione nelle categorie che lo consentono. Le versioni successive ampliano le prove a interazioni e capacità agentiche. Il punteggio combina le categorie previste. Metodologia BFCL, leaderboard e versioni.
È una parte del lavoro. Chiamare correttamente una funzione non garantisce di completare un processo con venti decisioni collegate.
τ-bench: conversazioni e azioni secondo le regole
Un cliente vuole cambiare un ordine. Devi verificare le condizioni, chiedere ciò che manca e aggiornare il sistema. Un messaggio rassicurante non risolve un database rimasto nello stato precedente.
τ-bench simula conversazioni con utenti e strumenti in domini regolati da policy. La valutazione confronta anche lo stato finale del database con quello atteso. τ²-bench aggiunge un dominio telecom in cui l’utente interviene nell’ambiente: l’agente deve guidarlo, oltre a usare i propri strumenti. τ-bench, τ²-bench.
Il punto dipende dall’esito del task secondo il protocollo. Le ripetizioni permettono poi di distinguere una riuscita occasionale da una procedura affidabile.
GAIA e BrowseComp: ricerca di informazioni con strumenti
Una domanda richiede un dato in un documento e un’altra informazione sul web. Li trovi, li combini e restituisci la risposta. GAIA usa domande da assistente che richiedono ragionamento, file e strumenti; la risposta finale è verificabile anche quando il percorso è lungo. Paper GAIA.
BrowseComp si concentra su ricerche web difficili con risposte brevi. Il correttore confronta l’esito con il riferimento e misura l’accuratezza. Progetto BrowseComp.
Ricerca disponibile, tempo e gestione del contesto influenzano il percorso. Inoltre, trovare la risposta attesa non certifica ogni citazione intermedia. Per un report aziendale servono sia il risultato sia fonti che sostengano le affermazioni.
OSWorld: agenti che lavorano nelle applicazioni desktop
Filtra un foglio elettronico e salva il risultato. È una richiesta quotidiana. OSWorld la porta dentro un ambiente di computer con applicazioni e file, e usa script per verificare lo stato prodotto. Progetto OSWorld.
Il file deve esistere, essere quello richiesto e contenere ciò che serve. La frase «operazione completata» non vale come prova. Versioni successive cambiano compiti e correzione: successi completi, risultati parziali e protocolli vanno tenuti distinti.
GDPval e Agents’ Last Exam: valutare il lavoro consegnato
GDPval passa ai deliverable professionali: analisi, documenti, fogli e altri prodotti del lavoro. Il dataset originale copre 44 occupazioni e la valutazione descritta da OpenAI include confronti eseguiti da esperti. GDPval.
GDPval-AA è una valutazione derivata, con propri agenti, giudici e rating. Il suo Elo va letto attraverso quella metodologia. Non è una percentuale di professioni automatizzate. GDPval-AA.
Agents’ Last Exam è distinto da Humanity’s Last Exam. Misura workflow professionali con riferimenti nascosti e criteri verificabili, dentro sandbox. I punteggi di successo riguardano la versione e i task eseguiti. Framework ALE.
Qui l’esame si avvicina alla scrivania: conta quello che viene consegnato. Quanto quella scrivania assomigli alla tua resta una domanda da fare. Il confronto fra OpenClaw e n8n approfondisce come cambiano gli strumenti e la progettazione del workflow.
8. Harness: perché lo stesso modello cambia punteggio
Torniamo ai venti punti dell’apertura. Il confronto tiene fermo il modello e cambia il modo in cui viene guidato. È un buon motivo per guardare la colonna «agente» con la stessa attenzione riservata alla colonna «modello».
L’harness organizza il ciclo: come presenta gli strumenti, che contesto conserva, quando verifica, come restituisce un errore e quando si ferma. Il nostro articolo BRIX-IA sull’harness sviluppa questo tema. Per leggere i benchmark la conseguenza è immediata: pesi uguali possono produrre percorsi e risultati diversi.
La scheda DeepSeek V4.1 Flash lo mostra anche con un confronto interno su Terminal-Bench 2.1: 84,1 con Codex, 88,0 con Claude Code, 90,6 con DSH Minimal. Sono risultati auto-riportati della stessa card, riferiti a quel setup. La classifica riguarda gli accoppiamenti testati. Scheda DeepSeek.
Un preprint del 1 ottobre 2026 confronta modelli e harness su tre benchmark e trova inversioni nell’ordine dei modelli. La scelta migliore cambia con il compito. Finding the Right Fit.
Anche l’ambiente conta. In un esperimento Anthropic su Terminal-Bench 2.0, modello e harness restano fissi mentre cambiano le risorse; fra le configurazioni estreme ci sono sei punti. Memoria e timeout possono interrompere un lavoro che il sistema avrebbe completato in condizioni diverse. Studio sull’infrastruttura. Il nostro articolo sulle infrastrutture della corsa all’AI allarga lo sguardo a chip, reti e raffreddamento.
Questo ridimensiona l’utilità della leaderboard come graduatoria assoluta dei pesi. Il numero conserva valore quando descrive il sistema realmente provato, con strumenti, ambiente e budget.
Se compri un agente, quel sistema è ciò che userai. Se scegli un modello per costruirci il tuo software, devi verificare quanto del risultato si trasferisca nella tua harness. Il 68–88% di Composio è un confronto su un campione di 25 task: mostra l’effetto nel suo perimetro, senza decretare un vincitore per qualsiasi uso.
9. Jev e decision model: accuratezza e calibrazione
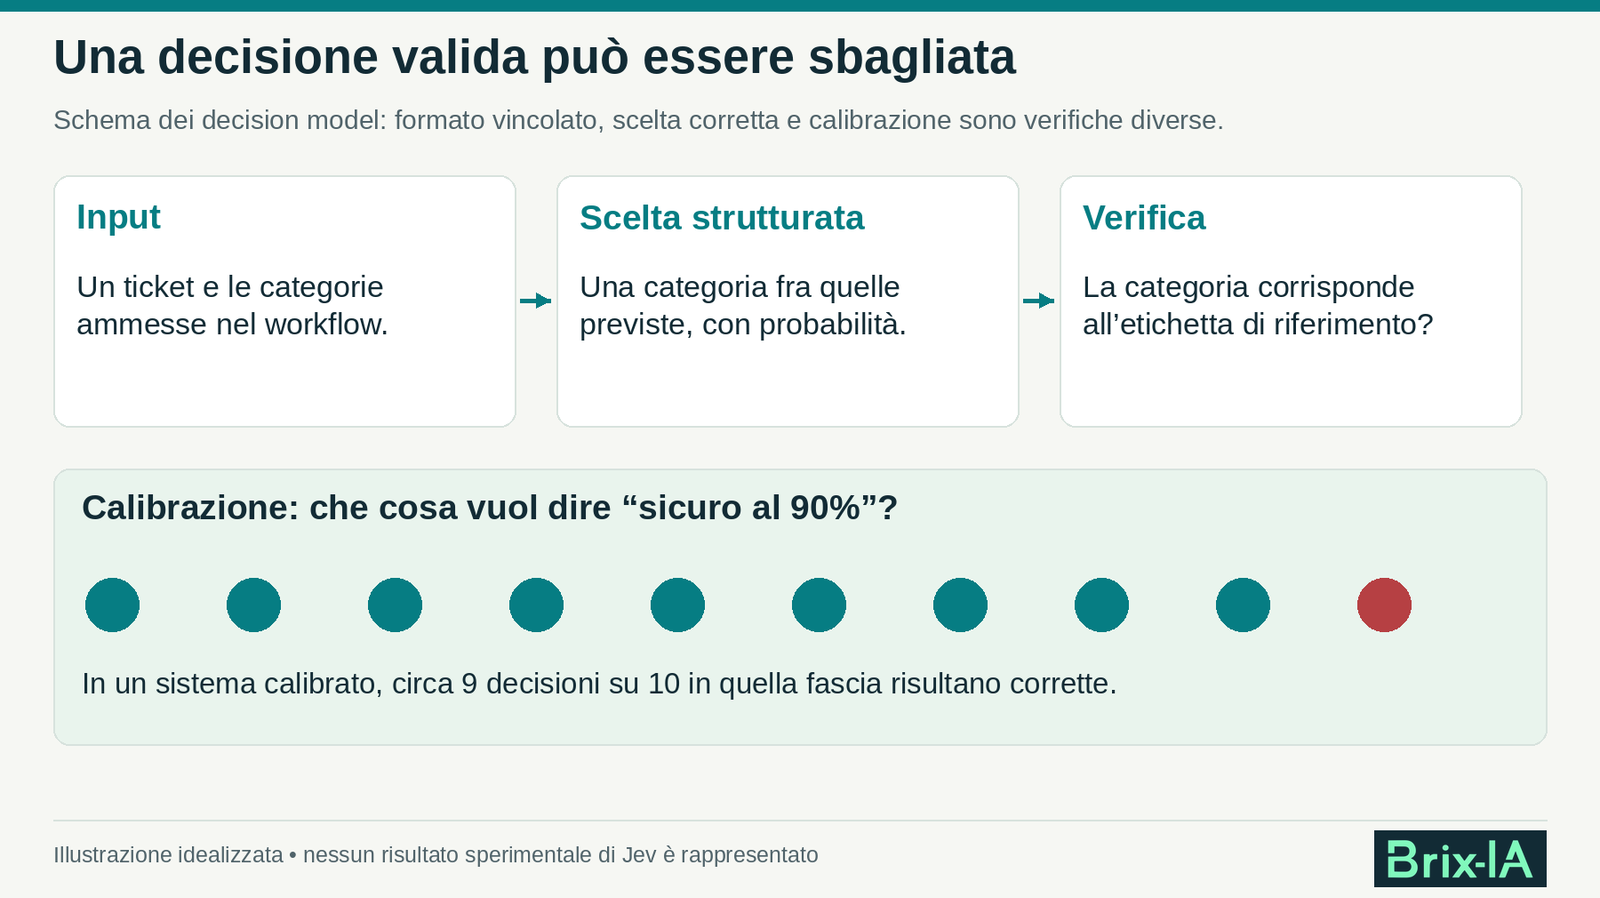
Finora abbiamo chiesto risposte, programmi e azioni. Un decision model restringe il campo: prende un input e sceglie fra opzioni definite. Un ticket può andare a «amministrazione», «assistenza» o «commerciale». Un documento può essere accettato, rifiutato o passato a un operatore.
Jev, presentato da TypeSafe come System One model, si colloca qui: decisioni strutturate e probabilità associate alle scelte. Il formato vincolato evita che il sistema inventi una quarta destinazione; resta da verificare se abbia scelto quella giusta. Presentazione di Jev.
Per questi modelli l’accuracy è un punto di partenza. Se 95 ticket su 100 sono ordinari, mandarli tutti nel percorso ordinario produce il 95% e perde ogni urgenza. Precision misura quante segnalazioni di urgenza erano corrette; recall quante urgenze vere sono state trovate. F1 combina le due con una media armonica. La scelta della soglia cambia il compromesso.
Conta anche la calibrazione. Fra le decisioni dichiarate sicure al 90%, circa nove su dieci dovrebbero risultare corrette. Il Brier score confronta probabilità ed esito: nel caso binario fa la media di (p − y)². Assegnare 0,9 a un evento che non accade produce 0,81 di errore; assegnare 0,1 produce 0,01. Più basso è meglio. Un modello calibrato aiuta a decidere quando coinvolgere una persona.
La dashboard TypeSafe confronta accuratezza, costo e tempo su quattro workflow, mantenendo lo stesso impianto. I riferimenti derivano dalle valutazioni di GPT-6 Astra e Claude Fable 5.1 con ragionamento elevato. Sono un riferimento costruito da modelli, da distinguere da etichette umane o esiti osservati. Workflow evals.
Un preprint indipendente confronta questi sistemi su 37 dataset e 346.009 richieste, trovando differenze anche nella calibrazione. Un altro studia 11 decisioni dentro workflow: azzeccare un singolo bivio e completare bene il processo sono misure diverse. Sono risultati recenti, da leggere nel loro perimetro. Valutazione dei decision model, valutazione dei workflow.
10. Benchmark per immagini: qualità e rispetto del prompt
«Due tazze rosse a sinistra di un vaso blu.» L’immagine può avere una luce splendida, ma se le tazze sono tre il compito è fallito. Se manca il vaso, anche. La qualità visiva e il rispetto della richiesta hanno bisogno di verifiche diverse.
FID confronta due distribuzioni di immagini attraverso le caratteristiche estratte da una rete. Calcola una distanza usando medie e covarianze: più bassa è meglio. Serve a confrontare insiemi di immagini generate e di riferimento. Non dice che ogni immagine rispetti il proprio prompt, e il valore non è una percentuale di successo. Paper FID.
GenEval rende la verifica più concreta: presenza di oggetti, numero, colori, posizione e associazione fra colore e oggetto, organizzati in sei gruppi. Un rilevatore controlla le immagini. Nelle prove di posizione o colore, anche gli oggetti necessari devono essere individuati perché il controllo abbia senso.
Il singolo esempio supera o fallisce i controlli previsti. Si calcola la media per gruppo e poi la media dei gruppi. Un risultato di 0,8 parla della riuscita di quei test: non certifica che l’80% delle immagini sia bello, vendibile o pronto per una campagna. GenEval, calcolo dei punteggi.
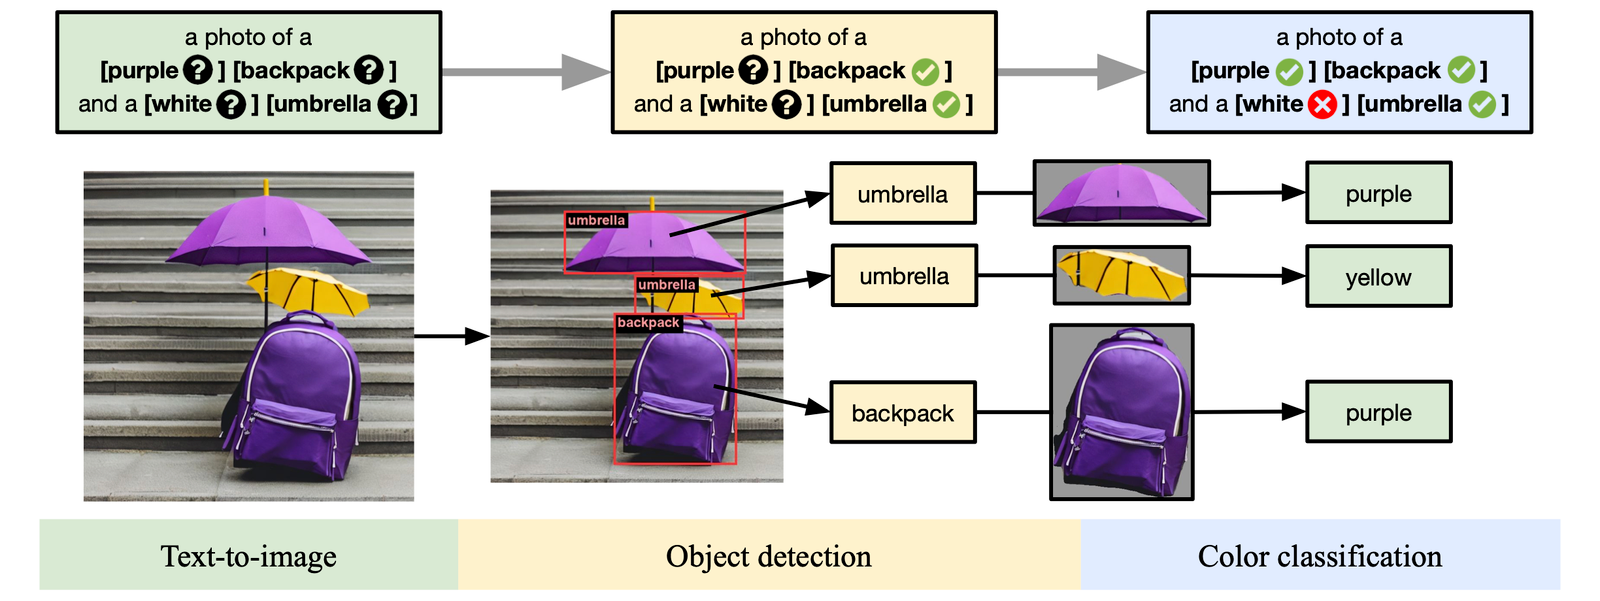
DPG-Bench lavora su prompt più densi, scomposti in domande visive. Per «una persona con cappotto verde tiene un ombrello», si può verificare la persona, il cappotto, il colore e l’ombrello. Il calcolo rispetta le dipendenze: se manca l’elemento padre, il dettaglio figlio non guadagna punti. I risultati delle domande vengono aggregati per immagine e poi per le immagini del prompt. Calcolo DPG-Bench.
GenEval2 usa verifiche visive delle istruzioni elementari e una misura probabilistica, Soft-TIFA. La media aritmetica riassume le capacità individuali; la media geometrica aiuta a penalizzare una composizione che va bene su molti dettagli e male su uno. L’aggregazione finale segue il protocollo del benchmark. GenEval2.
Qui il correttore è a sua volta un sistema che interpreta immagini. Può sbagliare un colore, una relazione o un oggetto piccolo. La pagella va letta insieme a ciò che riesce a riconoscere. Per scegliere un generatore servono anche esempi reali: una richiesta tipografica, un prodotto da mantenere coerente, una sequenza di immagini con lo stesso personaggio.
11. Benchmark di generazione 3D: una sedia va guardata anche da dietro
Una sedia può sembrare perfetta nell’immagine frontale e avere una quinta gamba dietro. Il benchmark 3D deve andare oltre la prima impressione: ruotare l’oggetto, controllare la coerenza delle viste e verificare che rappresenti la richiesta.
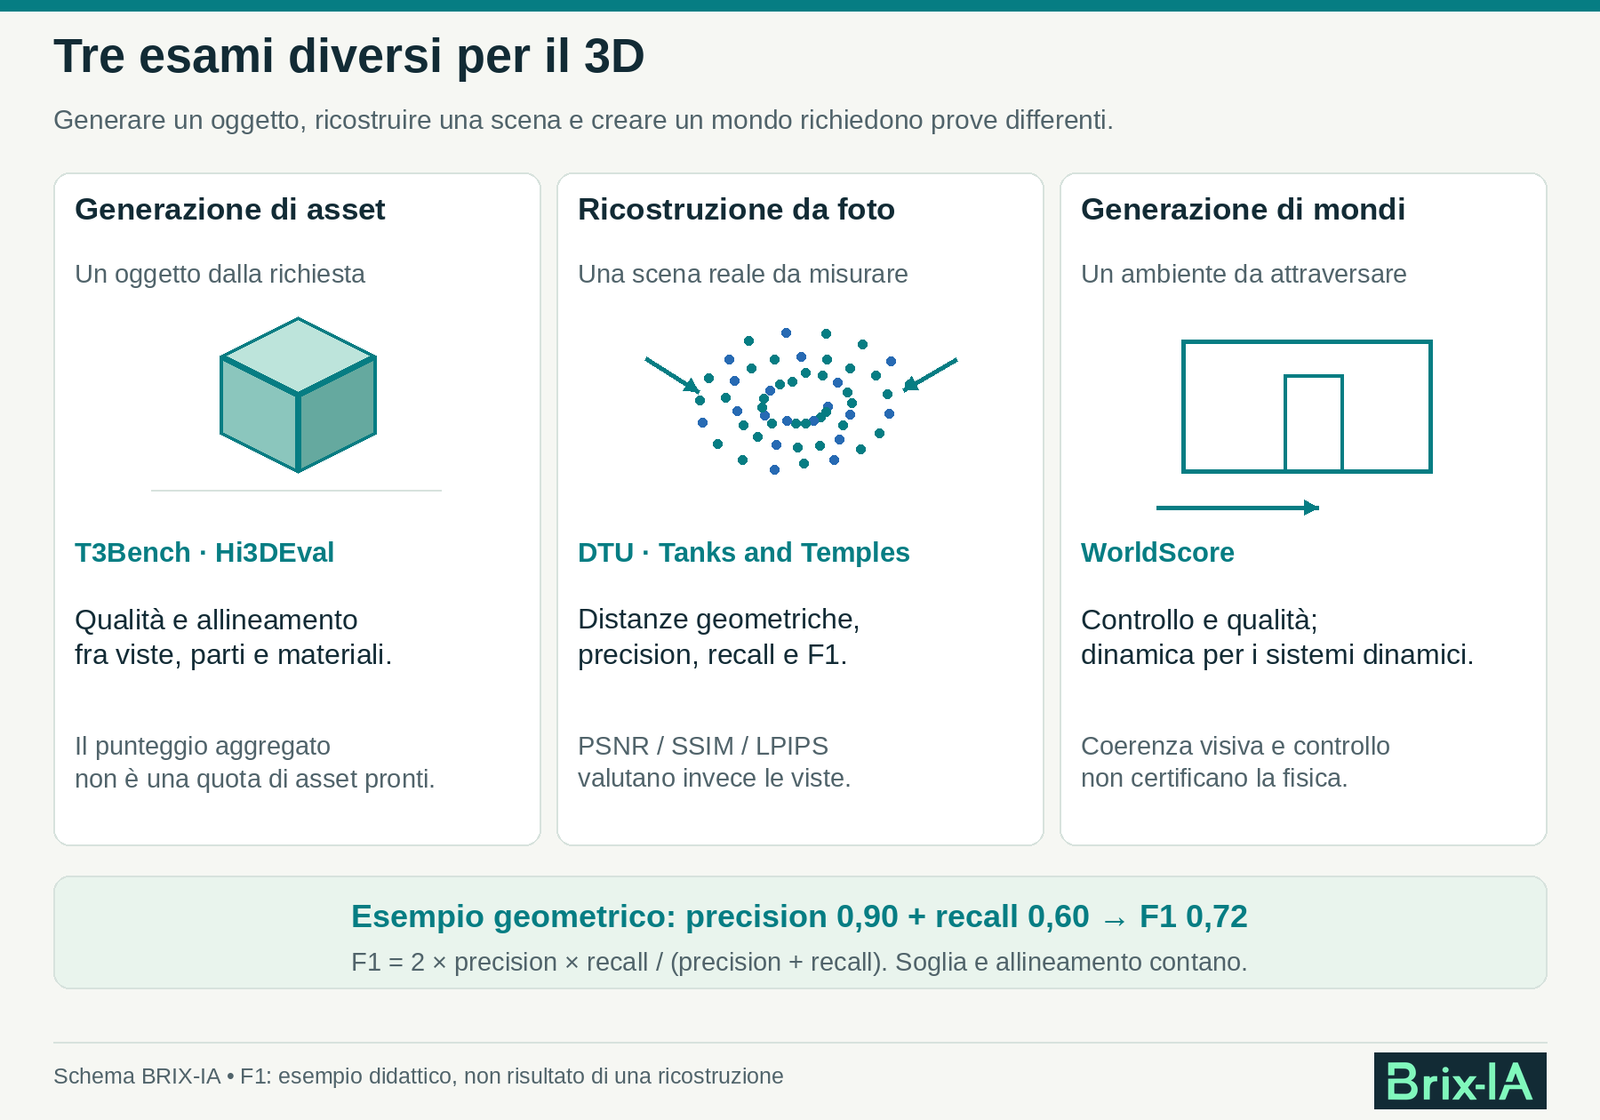
T3Bench divide i prompt in oggetti singoli, oggetti con un ambiente circostante e scene con più oggetti. Renderizza più viste per stimare qualità e coerenza; per l’allineamento al testo usa descrizioni delle viste e una valutazione linguistica. Il punteggio complessivo combina qualità e corrispondenza al prompt, riportate su scala 0–100. T3Bench.
Un 70 in questa scala non significa che sette modelli 3D su dieci siano corretti. È un punteggio aggregato delle componenti previste. Conviene vedere dove si perde: oggetto deformato, viste incoerenti, dettagli mancanti o richiesta interpretata male.
Hi3DEval amplia l’attenzione a parti e materiali, comprese proprietà come albedo e metallicità. Combina informazioni tridimensionali, viste dell’oggetto in rotazione e valutatori appresi per stimare la qualità. Anche qui si tratta di punteggi secondo una metodologia, da distinguere da una percentuale di asset utilizzabili. Hi3DEval.
L’uso finale aggiunge requisiti propri. Per un videogioco possono contare poligoni, materiali e facilità di modifica. Per una stampa 3D contano spessori e chiusura della mesh. Una valutazione della resa visiva può aiutare a scegliere il candidato; la verifica del file decide se quel candidato entra nel processo.
12. Ricostruzione 3D da fotografie: precision, recall e F1
Generare una sedia plausibile e ricostruire la sedia fotografata sono problemi diversi. Nel secondo caso esiste un oggetto reale: serve misurare quanto il risultato gli somigli, anche nelle zone difficili.
DTU offre acquisizioni controllate con riferimenti geometrici. Tanks and Temples valuta ricostruzioni di ambienti e oggetti reali; ETH3D mette a disposizione immagini e riferimenti per la ricostruzione multivista. Cambiano scene, condizioni e protocolli, perciò il nome del dataset è parte del risultato. DTU, Tanks and Temples, ETH3D.
Un metodo comune confronta le nuvole di punti entro una distanza scelta. Precision indica quanta parte della ricostruzione è vicina al riferimento; recall quanta parte del riferimento è coperta dalla ricostruzione. F1 combina le due: 2 × precision × recall / (precision + recall).
Con precision 0,90 e recall 0,60, F1 è 0,72. Il sistema ha prodotto punti abbastanza fedeli, ma ha lasciato fuori una parte dell’ambiente. Una stanza con una parete mancante può risultare precisa nelle superfici che ha ricostruito e incompleta nel complesso. Implementazione Tanks and Temples.
La soglia di distanza conta: un centimetro e dieci centimetri accettano errori differenti. Anche allineamento, scala e area valutata devono essere dichiarati prima del confronto.
Per metodi come NeRF si misura spesso la capacità di produrre viste nuove, confrontandole con fotografie tenute fuori dall’addestramento. PSNR misura la fedeltà dei pixel, SSIM la somiglianza strutturale, LPIPS una distanza percettiva appresa. PSNR e SSIM salgono quando il risultato migliora; LPIPS scende. Paper NeRF.
Una vista convincente non dimostra da sola l’accuratezza geometrica richiesta per un rilievo. Da una sola fotografia, inoltre, alcune superfici restano nascoste: il sistema può completarle in modo plausibile. Per valutare la ricostruzione bisogna distinguere ciò che è stato osservato da ciò che è stato inferito.
13. WorldScore e AA-3D: come si valutano i mondi generati
Immaginiamo di entrare in una stanza generata, girare a destra e tornare indietro. La porta dovrebbe essere ancora lì. Una sequenza spettacolare può perdere questa continuità, oppure ignorare il movimento di camera richiesto.
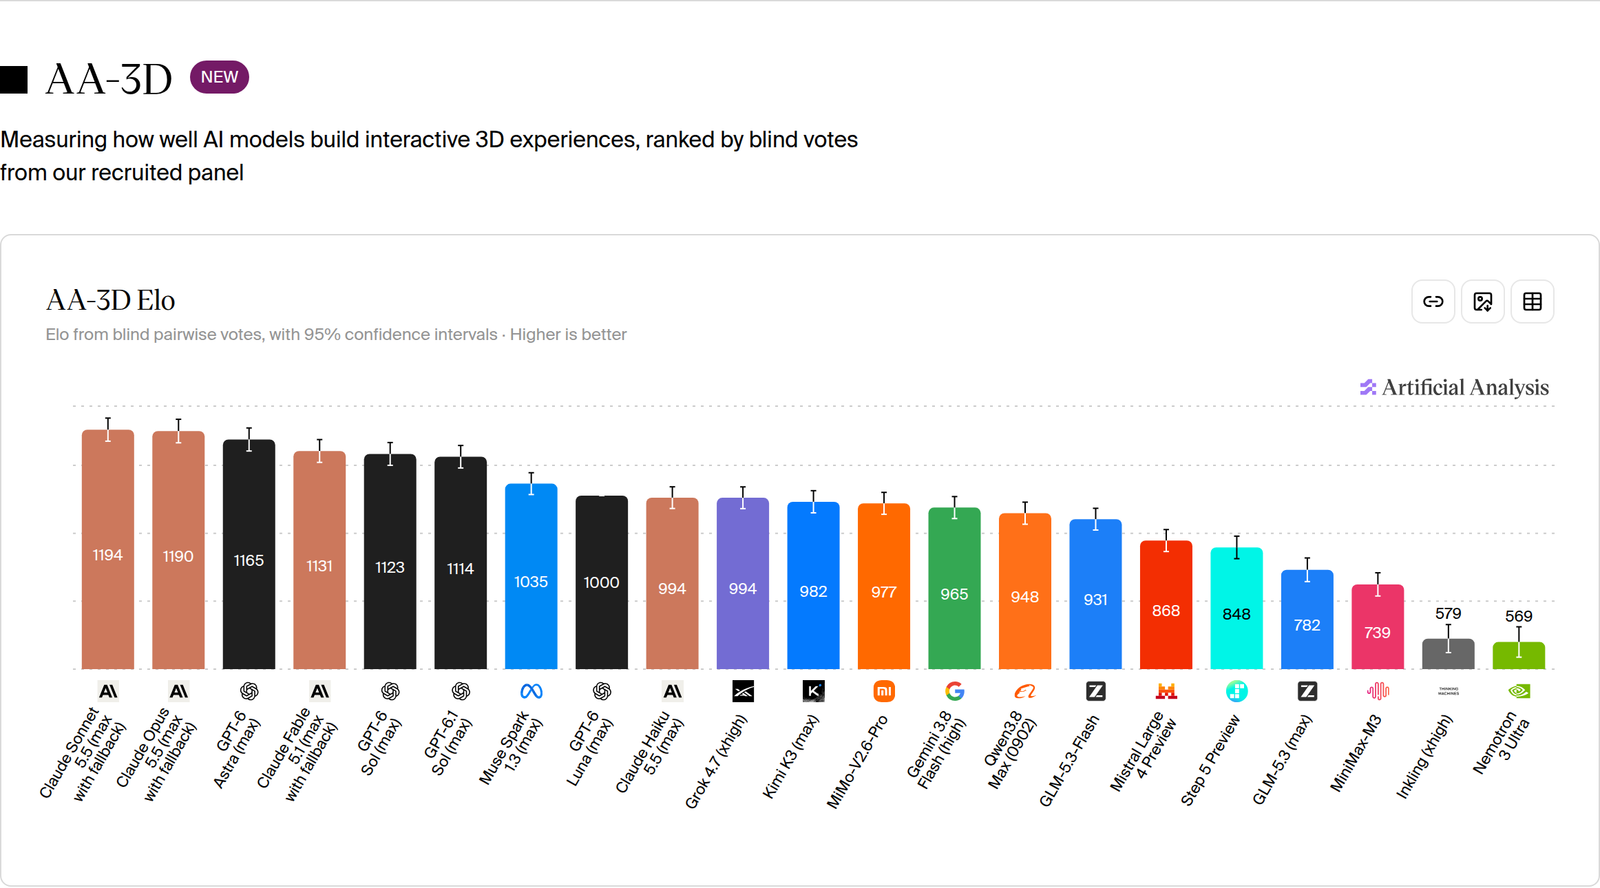
WorldScore prova a misurare generazione di mondi 3D, 4D e video attraverso sequenze, traiettorie di camera esplicite e istruzioni sulla scena successiva. Le dimensioni comprendono controllo della camera e del contenuto, qualità visiva e coerenza; per i sistemi dinamici si aggiungono correttezza, ampiezza e fluidità del movimento. WorldScore.
Le metriche vengono normalizzate usando limiti empirici e riportate su scala 0–100. WorldScore-Static aggrega controllo e qualità; WorldScore-Dynamic include anche le dimensioni del movimento. Quel 100 appartiene alla scala costruita dal benchmark: non è la quota di mondi perfettamente funzionanti. Paper e metodo.
La continuità visiva è un obiettivo già impegnativo. Un ambiente destinato a un gioco o a un simulatore richiede ulteriori verifiche su collisioni, interazioni e comportamento fisico. Il voto va collegato alla capacità effettivamente esaminata.
14. Leaderboard, Elo e indici: come leggere le classifiche AI
Le arene a confronto cieco rispondono a una domanda utile: quale risposta viene preferita? Dal confronto si può ricavare un rating. Il rating dipende da avversari, voti e campione delle richieste; non è una percentuale di risposte corrette. Abbiamo raccontato questo meccanismo anche nell’approfondimento su LMArena e i confronti tra chatbot.
Anche i giudici automatici hanno preferenze. Il lavoro che accompagna MT-Bench analizza effetti di posizione, prolissità e preferenza del giudice per risposte simili alle proprie. Un testo più lungo può sembrare migliore senza risolvere meglio il compito. MT-Bench e giudici.
Uno studio sulle leaderboard del 2025 mostra inoltre come selezione delle versioni e modalità di campionamento possano influenzare la graduatoria. È un’analisi di pratiche specifiche, utile per chiedere trasparenza sulle regole del confronto. The Leaderboard Illusion.
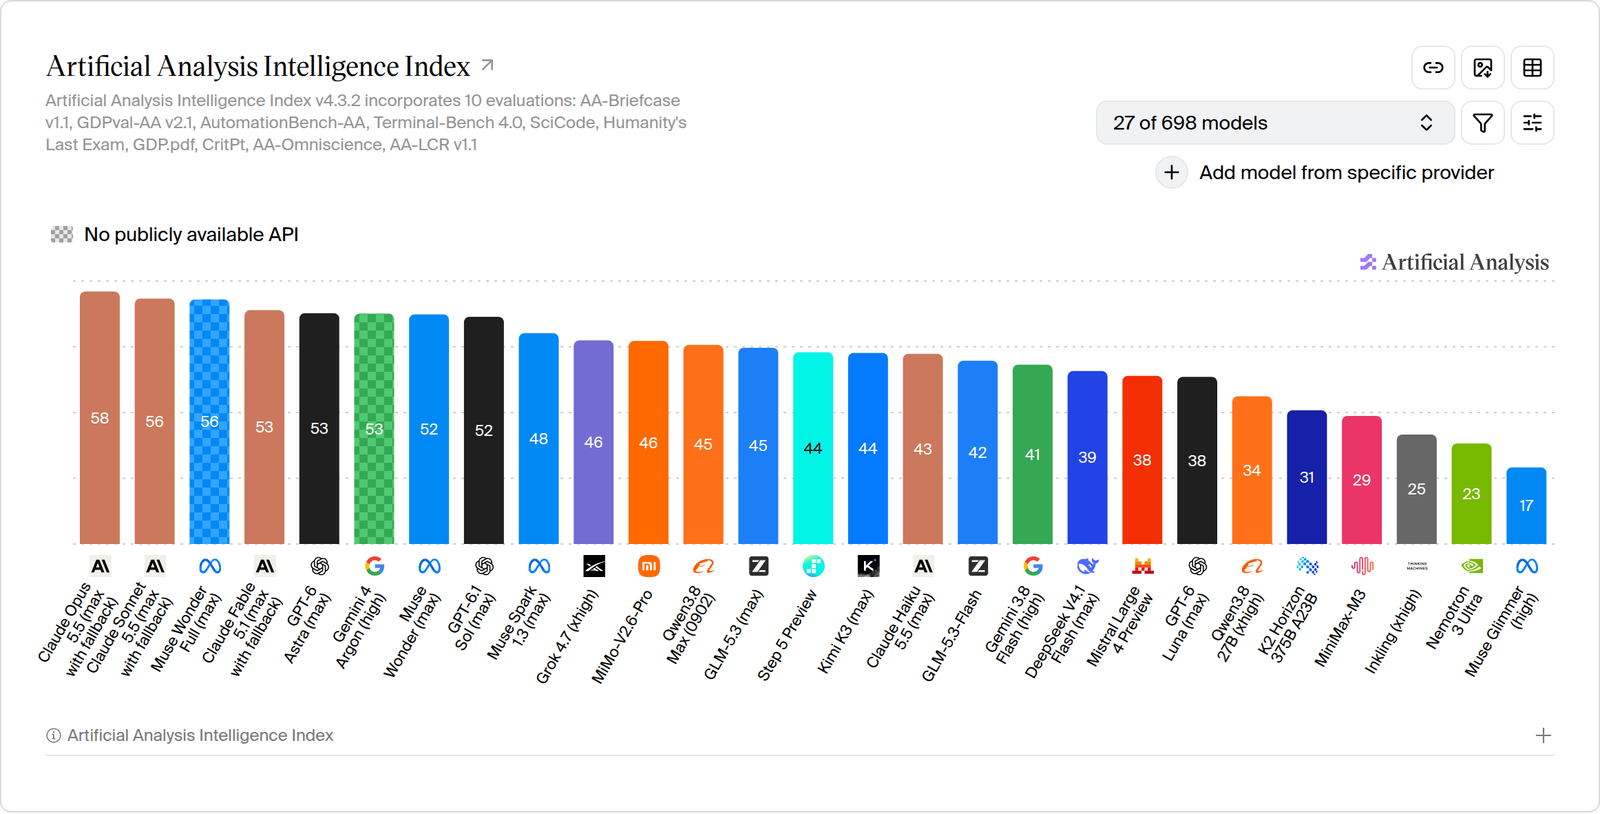
Gli indici compositi, come quello di Artificial Analysis, riuniscono più prove secondo una metodologia. Sono comodi per orientarsi. La scelta dei benchmark, dei pesi e della normalizzazione incorpora però un’idea di ciò che conta. Se cambia la metodologia, va verificata la confrontabilità con il vecchio indice. Metodologia Artificial Analysis.
15. Come scegliere un modello AI con benchmark aziendali
A questo punto la leaderboard può fare il suo lavoro: restringere i candidati. La scelta finale richiede un campione del lavoro che vuoi affidare al sistema.
Per l’estrazione documentale, prepara importi e righe attesi. Per un agente, verifica file e stato finale. Per lo smistamento, guarda le classi che vengono confuse. Definisci prima cosa rende accettabile il risultato e conserva casi distinti da quelli usati per migliorare prompt e pipeline. Includi il processo attuale nel confronto: un parser semplice può essere un concorrente serio.
Misura anche il costo per risultato accettabile. In un esempio inventato, spendere 8 euro su 100 task con 80 successi dà 10 centesimi per successo; spendere 18 euro con 90 successi dà 20 centesimi. Il secondo sistema copre più casi: quei dieci casi aggiuntivi possono giustificare la spesa. Nel conto entrano tentativi falliti, strumenti, infrastruttura e minuti di revisione. Per le prove su macchine proprie, la guida all’hardware per gli LLM in locale offre il quadro da affiancare alle misure di qualità.
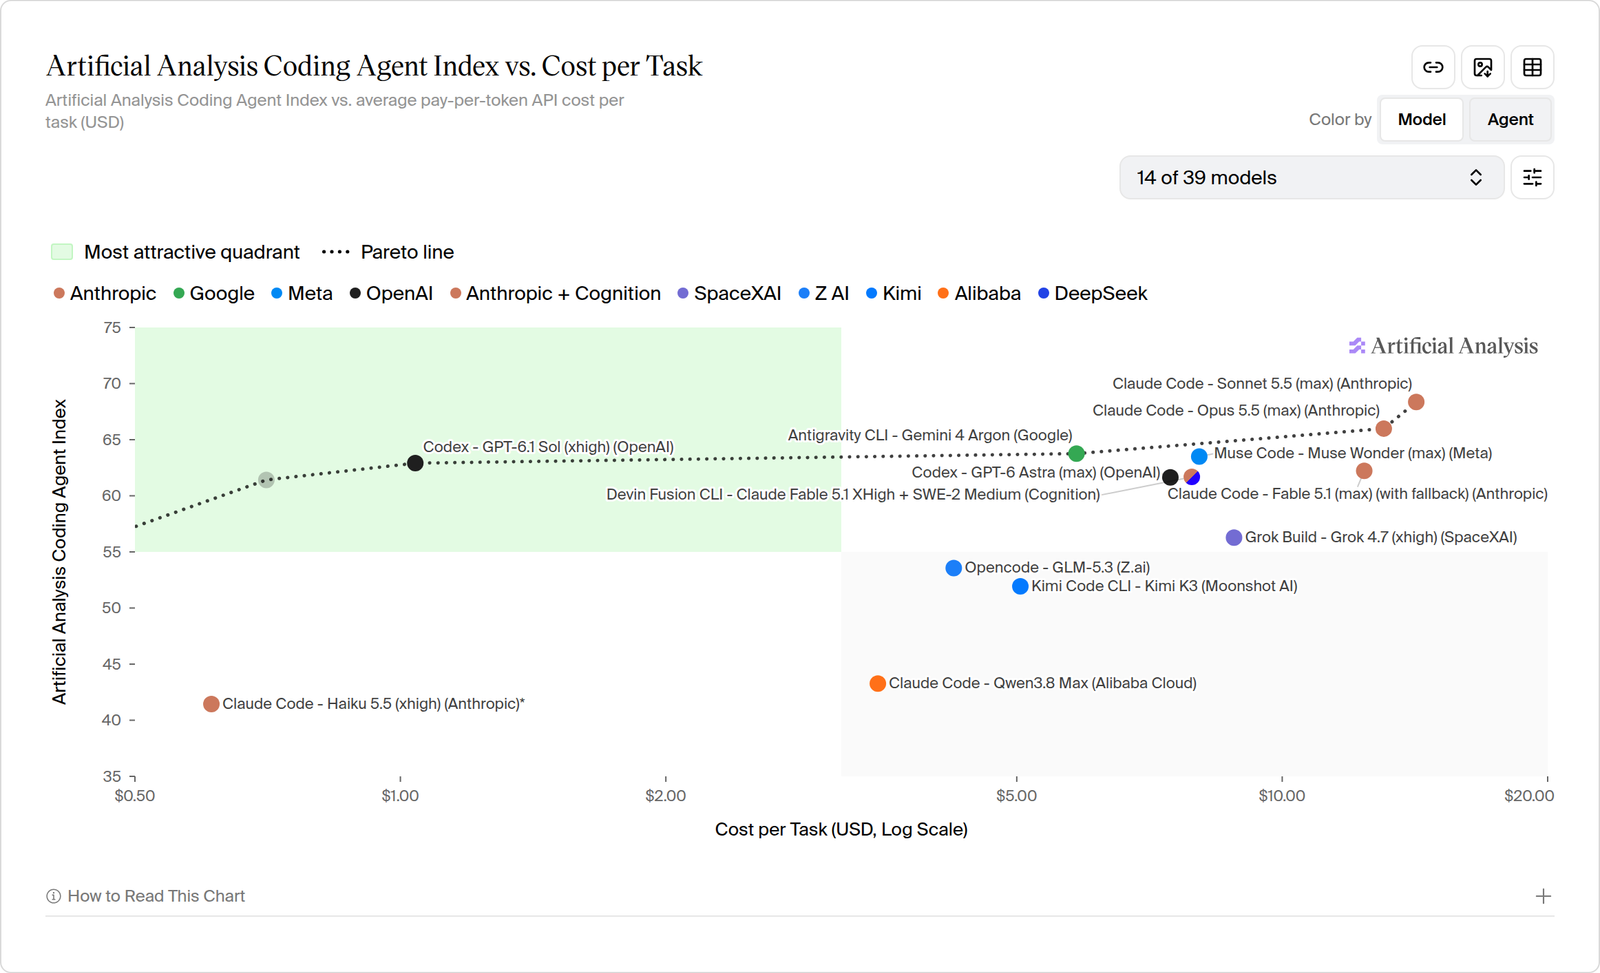
Ripetere aiuta a vedere la stabilità; aggiungere casi indipendenti aiuta a misurare la varietà del lavoro. Sono due esigenze diverse. Differenze piccole su pochi esempi meritano prudenza, e intervalli di confidenza sovrapposti non dimostrano da soli equivalenza.
Torniamo infine al 68 e all’88 dell’apertura. Dietro ciascun numero c’è un sistema, un esame e una procedura di correzione. Quando queste tre cose sono visibili, il benchmark diventa uno strumento per scegliere. Il passo successivo è verificare se quel sistema sa fare il tuo lavoro.
Schede dei produttori e metodologie consultate il 12 ottobre 2026. I risultati riferiti a specifiche versioni e configurazioni vanno letti con quella data e quel perimetro.